LLM wikiLLM wiki : un second cerveau que l’IA écrit et tient en ordre.
Un LLM wiki est une base de connaissances personnelle qu’un agent IA rédige et entretient pour vous. Vous déposez des sources dans un dossier ; le modèle les compile en pages markdown reliées entre elles, répond à vos questions à partir de ces pages et les relit pour y traquer les erreurs. Andrej Karpathy a décrit cette approche en avril 2026, et elle a lancé la vague des seconds cerveaux IA construits avec Claude Code et Obsidian. Voici ce qu’il a proposé, ce qui la distingue du RAG, et un guide honnête pour en construire un.
Créé par Andrej Karpathy, qui a décrit l’approche en avril 2026.
Un LLM wiki est une base de connaissances personnelle construite et entretenue par un grand modèle de langage, et non rédigée par vous. Vous réunissez dans un dossier des sources : articles, publications scientifiques, transcriptions, notes. Un agent IA lit chacune d’elles et intègre ce qu’il en a retenu dans un ensemble de pages markdown reliées entre elles : un résumé de la source, des pages pour les personnes, les idées et les termes qu’elle mentionne, et des retouches sur toutes les pages existantes qui s’y rapportent. L’idée vient d’Andrej Karpathy, chercheur et pédagogue en IA, membre fondateur d’OpenAI puis directeur de l’IA chez Tesla. Il a décrit sa propre configuration dans un post sur X intitulé « LLM Knowledge Bases » le 2 avril 2026, puis, deux jours plus tard, a publié l’approche sous la forme d’un gist GitHub appelé « LLM Wiki ». Ce sont ces deux publications que l’on désigne quand on parle du « second cerveau de Karpathy », ou d’un second cerveau IA avec Claude.
Le gist décrit trois couches. Les sources brutes sont vos documents choisis, et elles sont traitées comme immuables : le modèle les lit sans jamais les modifier, si bien qu’elles restent la source de vérité. Le wiki est un répertoire de fichiers markdown écrits par le modèle : résumés, pages d’entités, pages de concepts, comparaisons, une vue d’ensemble et une synthèse tenue au fil de l’eau. Karpathy le dit explicitement : cette couche appartient au modèle. Vous la lisez ; le modèle l’écrit. La troisième couche est le schéma, un document comme CLAUDE.md pour Claude Code ou AGENTS.md pour Codex d’OpenAI, qui indique à l’agent comment le wiki est organisé et quelle procédure suivre pour chaque tâche. Il y voit le fichier de configuration clé, celui qui transforme un chatbot généraliste en mainteneur discipliné, et s’attend à ce que vous l’affiniez avec le modèle à mesure que vous découvrez ce dont votre sujet a besoin.
Trois opérations reposent sur ces couches. L’ingestion (ingest) : vous déposez une nouvelle source dans le dossier des sources brutes et demandez à l’agent de la traiter. Il lit la source, en discute les points principaux avec vous, rédige une page de résumé, met à jour l’index ainsi que les pages d’entités et de concepts concernées, puis ajoute une ligne à un journal. Karpathy estime qu’une source peut toucher 10 à 15 pages du wiki, et dit préférer intégrer les sources une par une en restant impliqué. L’interrogation (query) : vous posez des questions, et l’agent trouve les pages pertinentes, les lit et répond en citant ses sources, sous forme de page, de tableau, de diaporama ou de graphique. Le contrôle (lint) : de temps en temps, vous lui demandez un bilan de santé du wiki pour repérer les contradictions entre pages, les affirmations dépassées par des sources plus récentes, les pages orphelines vers lesquelles aucun lien ne pointe, les concepts qui mériteraient leur propre page et les lacunes qu’une recherche web pourrait combler.
Ce qui le distingue, c’est le moment où le travail se fait. La plupart des outils qui répondent à partir de vos documents, et Karpathy cite parmi eux NotebookLM et l’envoi de fichiers dans ChatGPT, vont chercher des fragments au moment où vous posez la question et reconstruisent une réponse de zéro à chaque fois. Rien ne s’accumule. Dans un LLM wiki, la synthèse est écrite une fois, puis tenue à jour, si bien que les renvois et les contradictions signalées existent déjà quand vous posez votre question. Au moment de son post, son wiki sur un sujet de recherche comptait environ 100 articles et 400 000 mots. Il écrivait qu’il s’attendait à avoir besoin d’un « RAG sophistiqué », mais que les fichiers d’index et les courts résumés tenus par le modèle suffisaient à cette échelle. Les bonnes réponses retournent dans le wiki sous forme de nouvelles pages, si bien que ses questions, selon ses mots, « s’additionnent » dans la base de connaissances.
L’idée s’est répandue très vite. En novembre 2026, le post sur X dépassait les 22 millions de vues, et quelques jours après sa publication circulaient déjà des tutoriels vidéo, des modèles prêts à l’emploi et des outils construits sur l’idée. Une partie de l’attrait tient à l’image que propose le gist : Obsidian comme l’éditeur dans lequel vous naviguez, le modèle comme le programmeur, le wiki comme la base de code qu’il maintient. Mais le gist est volontairement abstrait. Il décrit une approche, pas un produit, et Karpathy concluait son post en disant qu’il y avait de la place pour un vrai produit à la place de son « assemblage bricolé de scripts ». La suite de ce guide présente une façon concrète de mettre l’approche en œuvre, avec ce qui tend à mal tourner. Si l’idée générale est nouvelle pour vous, notre explication du second cerveau IA (en anglais) en pose le contexte.
À la source
Expliqué en vidéo
Une mise en place pour débutants, du coffre au premier lint, avec Obsidian et Claude Code. Teacher’s Tech, avril 2026.
Pour qui
À qui s’adresse un LLM wiki
Les chercheurs qui creusent un seul sujet
C’est le cas pour lequel Karpathy l’a conçu : des semaines ou des mois de lecture de publications, d’articles et de rapports sur une seule question, avec une thèse qui évolue en chemin. Le wiki vous donne une page par publication, une page pour chaque méthode, jeu de données ou personne qui revient sans cesse, et une page de synthèse qui change quand les preuves changent. L’habitude la plus précieuse ici consiste à signaler les contradictions : quand la source 23 contredit la source 4, le modèle le note sur les deux pages au lieu de compter sur votre mémoire. L’exemple détaillé plus bas suit un mois de lecture de ce type.
Les lecteurs de longs livres et de cours
Le gist suggère d’intégrer chaque chapitre d’un livre au fil de la lecture et de laisser le modèle créer des pages pour les personnages, les lieux, les thèmes et les fils de l’intrigue, si bien qu’à la dernière page, vous disposez d’un wiki compagnon, une version personnelle des wikis de fans que des bénévoles construisent pendant des années. Un cours fonctionne de la même manière : une page par séance, une page par concept et un glossaire qui se tient à jour tout seul. Si vous tenez déjà un commonplace book (carnet de lieux communs), c’est le même réflexe, avec en prime un secrétaire qui se charge de l’indexation.
Les personnes qui documentent leur propre vie
Karpathy cite aussi des usages personnels : objectifs, santé, psychologie et développement personnel, à partir d’entrées de journal, d’articles et de notes de podcasts réunies en un portrait structuré de vous-même. C’est là que l’approche est la plus tentante et la plus délicate. Un wiki sur votre santé ou vos relations est un wiki que vous envoyez, page après page, à un fournisseur de modèles. Lisez la section de ce guide consacrée aux risques avant d’y mettre quoi que ce soit que vous ne voudriez pas voir stocké sur les serveurs de quelqu’un d’autre, et gardez ce coffre hors des dossiers partagés ou synchronisés.
Les petites équipes dont personne n’entretient le savoir
Le gist imagine aussi un wiki interne alimenté par des fils de discussion, des transcriptions de réunions, des documents de projet et des appels clients, avec des personnes qui relisent les modifications du modèle. L’article de VentureBeat citait une réponse selon laquelle chaque entreprise possède un dossier brut que personne n’a jamais compilé (Karpathy convenait qu’il y avait là la place pour un nouveau type de produit), ainsi que la mise en garde d’un fondateur : quand le savoir informel de milliers d’employés se contredit, le saut devient bien plus difficile. Pour cinq personnes et un seul disque partagé, l’approche est réaliste. Pour une entreprise, c’est un projet avec des responsables, des droits d’accès et des relectures, pas un script bricolé en un week-end.
Les principes clés
Pourquoi l’approche fonctionne
Compiler une fois, tenir à jour
L’idée centrale du gist est que le wiki est un artefact persistant dont la valeur s’accumule. Lire une source et la relier au reste se fait une seule fois, à l’ingestion, et le résultat est conservé sous forme de pages au lieu d’être jeté après une seule réponse. Les questions suivantes partent d’un travail déjà fait. C’est l’inverse d’une fenêtre de chat, où chaque nouvelle conversation repart de rien, une limite que nous examinons dans pourquoi ChatGPT n’est pas un second cerveau (en anglais).
Les sources restent intactes
Le dossier des sources brutes est en lecture seule pour le modèle. Cette seule règle rend tout le système vérifiable : n’importe quelle page du wiki peut être confrontée au document dont elle provient, et si le wiki dérape, vous pouvez le reconstruire à partir des sources. C’est aussi pour cela que l’approche fonctionne avec de simples fichiers. Obsidian conserve les notes sous forme de fichiers Markdown dans un dossier sur votre propre disque et se rafraîchit quand un autre programme les modifie, si bien que l’agent et vous pouvez travailler dans le même dossier en même temps.
Le schéma, c’est la discipline
Livré à lui-même, un modèle nommera les pages de façon incohérente, oubliera l’index et résumera différemment à chaque fois. Le fichier de schéma fixe les conventions par écrit, et l’agent le lit au début de chaque session. Claude Code charge automatiquement le CLAUDE.md d’un projet, mais la documentation d’Anthropic sur la mémoire prend soin de préciser que ce fichier est traité comme du contexte, pas comme une configuration imposée : des règles précises et concises sont suivies plus fidèlement que de longues règles. La cohérence vient des règles écrites, pas du modèle.
Le vrai goulot d’étranglement, c’est l’intendance
Pour Karpathy, si l’approche fonctionne, c’est que la partie fastidieuse d’une base de connaissances n’est ni la lecture ni la réflexion, mais l’intendance : mettre à jour les renvois, actualiser les résumés, noter les contradictions sur des dizaines de pages. On abandonne les wikis parce que cette charge grandit plus vite que leur valeur. Un modèle, lui, ne s’en lasse pas. Karpathy rattache l’idée au Memex imaginé par Vannevar Bush en 1945, une réserve privée de documents reliés par des pistes associatives, et ajoute que ce que Bush n’avait pas su résoudre, c’était la question de savoir qui assurerait l’entretien.
Erreurs courantes
Là où les LLM wikis dérapent (et comment y remédier)
Intégrer cent fichiers d’un coup dès le premier jour
Il est tentant de lâcher l’agent sur un dossier de PDF et de revenir une heure plus tard. Résultat : un wiki que vous n’avez jamais lu, bâti sur des conventions que vous n’avez jamais vérifiées, où chaque erreur des débuts est recopiée cent fois. Karpathy dit que l’ingestion par lots est possible avec moins de supervision, mais qu’il préfère une source à la fois, en lisant les résumés et en indiquant sur quoi insister. La solution : intégrer les dix premières sources une par une, ajuster le schéma après chacune, et ne passer aux lots qu’une fois que les pages ressemblent à ce que vous voulez.
Des pages sans provenance
Une phrase du wiki sans lien vers une page de source est une phrase que vous ne pouvez pas vérifier, et si elle est fausse, l’ingestion suivante risque de s’appuyer dessus. Les résumés écrits par un modèle peuvent contenir des affirmations que la source n’a jamais faites. La solution : une règle du schéma qui exige que chaque phrase factuelle se termine par un lien vers la page de la source dont elle provient, plus une vérification de lint qui liste les phrases sans source.
Un schéma qui tourne au manuel
Chaque agacement devient une nouvelle règle, et six semaines plus tard, CLAUDE.md fait 600 lignes. Anthropic recommande de viser moins de 200 lignes par fichier CLAUDE.md, car les fichiers plus longs consomment plus de contexte et sont moins bien respectés. La solution : limiter le schéma à l’arborescence, au format des pages et aux règles impératives, et déplacer les procédures longues comme l’ingestion et le lint dans des skills (compétences), qui ne se chargent que lorsque vous les appelez.
Laisser l’agent libre de tout faire dans le dossier
Un agent qui peut tout modifier peut aussi écraser une source, supprimer une page ou renommer la moitié du coffre. La solution tient en trois petites habitudes : démarrer les sessions dans un mode d’autorisation qui demande la permission avant chaque modification, tant que la procédure n’a pas gagné votre confiance ; écrire « ne jamais modifier raw/ » dans le schéma ; et garder le coffre sous git, pour que chaque changement puisse être relu dans un diff et annulé.
Construire des outils au lieu de lire
L’approche encourage le bricolage : recherche sur mesure, tableaux de bord, scripts, plugins. Il est facile de passer un mois à perfectionner la machine sans jamais lire les pages qu’elle a produites. Le bilan publié après un mois d’usage dans R&D World jugeait que le temps passé à entretenir le wiki et le temps gagné s’équilibraient à peu près. La solution : n’ajouter des outils que lorsqu’une vraie question échoue, comme l’a fait Karpathy avec le petit moteur de recherche qu’il a écrit pour que l’agent puisse traiter des requêtes plus vastes.
Le guide complet
Construire un LLM wiki avec Claude Code et Obsidian
Comment fonctionne la boucle
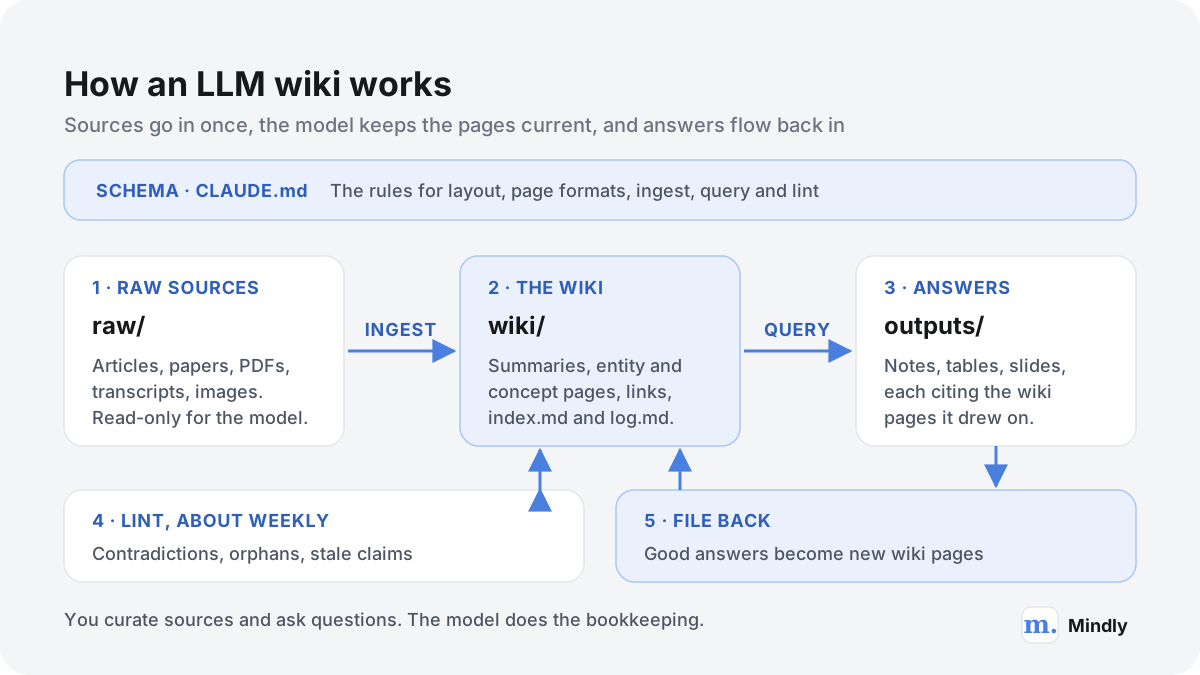
Tout LLM wiki tourne sur la même boucle : une source entre, des pages sont mises à jour, des questions reçoivent une réponse, les bonnes réponses sont reversées au wiki, et l’ensemble est vérifié de temps en temps.
Les sources entrent une seule fois. Le modèle tient les pages à jour, et vos questions viennent les enrichir.
Prenons une seule ingestion. Vous enregistrez dans le dossier des sources brutes un article sur une nouvelle étude et demandez à l’agent de le traiter. Il rédige une page de résumé de l’article. Il remarque que l’étude utilise une méthode qui a déjà sa page de concept : il y ajoute un paragraphe avec un lien de retour. L’article mentionne deux chercheurs ; l’un a déjà une page d’entité, qui reçoit une ligne de plus, l’autre en obtient une nouvelle. L’article contredit une affirmation de la page de synthèse, si bien que les deux pages reçoivent une note sur ce désaccord. Enfin, l’index gagne une ligne et le journal une entrée. Cela fait sept fichiers modifiés pour un court article. Karpathy estime qu’une source typique touche 10 à 15 pages, et c’est exactement le genre de travail que personne ne continue à faire à la main.
Les deux fichiers qui font tenir l’ensemble
Le gist désigne deux fichiers particuliers. index.md est le catalogue : chaque page du wiki y figure avec un lien, un résumé d’une ligne et, si vous le souhaitez, des métadonnées comme une date ou le nombre de sources sur lesquelles elle s’appuie, le tout regroupé par catégorie. L’agent le met à jour à chaque ingestion et le lit en premier à chaque question, puis n’ouvre que les pages dont il a besoin. Karpathy indique que cela fonctionne bien à une échelle moyenne, autour de 100 sources et quelques centaines de pages, sans la moindre recherche par embeddings.
log.md est l’historique : la liste datée de tout ce qui s’est passé, ingestions, questions et passes de lint, où les entrées s’ajoutent sans jamais être modifiées. Karpathy conseille de commencer chaque entrée par le même préfixe, par exemple « ## [2026-04-02] ingest | Titre de l’article », pour que les outils ordinaires de la ligne de commande puissent le lire. La commande grep "^## \[" log.md | tail -5 affiche les cinq dernières entrées. Le journal rappelle aussi à l’agent, au début d’une nouvelle session, ce qu’il a fait récemment. Ce n’est pas un détail : sans cela, chaque session commence avec une mémoire vide.
LLM wiki vs RAG
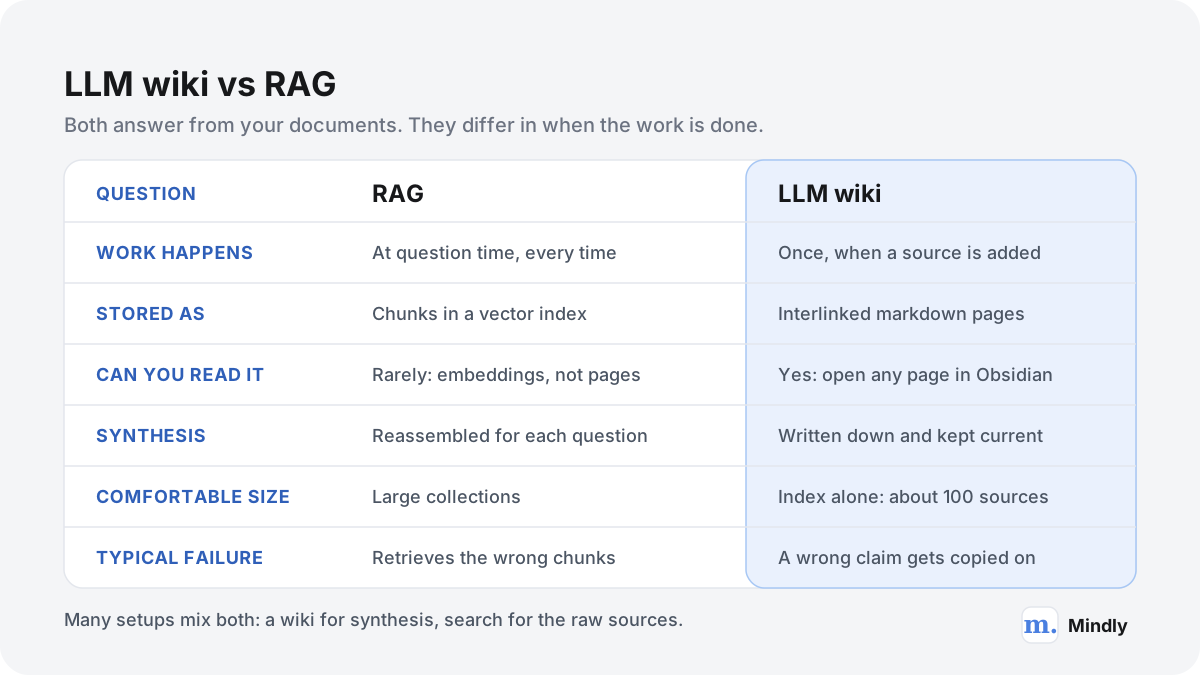
Les deux approches s’attaquent au même problème, obtenir de bonnes réponses à partir de vos propres documents, et diffèrent surtout par le moment où le modèle fait le travail.
Le terme de génération augmentée par récupération (RAG, pour retrieval-augmented generation) vient d’un article de 2020 signé Patrick Lewis et ses collègues, qui associait les connaissances intégrées d’un modèle de langage à un module de récupération chargé de chercher dans une base externe, en l’occurrence un index vectoriel dense de Wikipédia. Dans l’usage courant, RAG désigne aujourd’hui ceci : découper vos documents en fragments, transformer chaque fragment en embedding, stocker ces embeddings dans un index vectoriel et, quand une question arrive, aller chercher les fragments les plus proches pour les confier au modèle, qui rédige la réponse. Des outils comme NotebookLM fonctionnent ainsi : c’est pour cela qu’on les prend en main si vite, et que chaque question y est traitée plus ou moins à partir de zéro. Notre analyse de NotebookLM comme second cerveau détaille ce que cela implique en pratique.
Un LLM wiki déplace le travail au moment où une source arrive. Le modèle lit le document entier, décide de ce qui compte et l’écrit dans des pages durables. Au moment de la question, il lit ses propres pages, déjà résumées, reliées et mises en cohérence. Le RAG paie la compréhension à chaque question ; un wiki la paie une fois par source et garde le reçu.
Même objectif, calendrier différent. Beaucoup de configurations réelles utilisent les deux.
Question
RAG
LLM wiki
Quand le modèle fait-il le travail ?
À chaque question
Une fois par source, à l’ingestion, plus des passes de lint régulières
Qu’est-ce qui persiste d’une question à l’autre ?
Les fragments et leurs embeddings
Résumés, pages de concepts et d’entités, liens, un index et un journal
Peut-on le lire et le corriger ?
Difficilement ; la base est faite de vecteurs
Oui ; chaque page est un fichier markdown que vous pouvez ouvrir et modifier
Questions qui couvrent de nombreuses sources
Dépendent de la récupération simultanée de tous les fragments pertinents
Partent de pages de synthèse qui relient déjà les sources
Profil de coût
Ajouter des documents coûte peu ; chaque question paie la récupération et la lecture
Chaque source coûte une passe d’ingestion qui touche de nombreuses pages ; les questions lisent moins de pages, plus denses
Taille confortable
Collections volumineuses et qui changent vite
Environ 100 sources et des centaines de pages avec le seul index ; au-delà, ajouter une recherche
Échec typique
Le bon passage n’est jamais récupéré
Une affirmation fausse est écrite dans une page, puis recopiée ailleurs
Comparaison établie d’après le gist de Karpathy et l’article fondateur du RAG. Le chiffre d’échelle du wiki est une estimation de Karpathy, pas une limite stricte.
Quand l’un ou l’autre l’emporte
Le RAG pour les gros volumes qui changent. Des milliers de documents, des tickets de support, un drive d’entreprise qui bouge tous les jours : rédiger des pages à l’avance pour tout cela coûterait bien plus que ce que cela rapporte. La récupération passe à l’échelle ; la compilation soignée, non.
Le RAG pour retrouver un passage précis. Une question comme « que dit la clause 7 du bail ? » appelle le texte original exact, pas le résumé d’un résumé. La récupération mène tout droit au passage source.
Le wiki pour un sujet avec lequel vous allez vivre. Une thèse, une longue enquête, un livre en cours d’écriture : des mois de lecture sur un sujet bien délimité, c’est là qu’une synthèse compilée se rentabilise.
Le wiki quand les contradictions comptent. Le RAG répondra sans états d’âme à partir du premier fragment qu’il trouve. Un wiki qui signale les désaccords dès l’ingestion vous prévient que le domaine est divisé avant que vous citiez l’un ou l’autre camp.
Le wiki quand vous voulez lire le savoir, pas seulement l’interroger. Des pages que vous pouvez parcourir, relier et corriger, c’est tout autre chose qu’un index que vous pouvez seulement questionner.
Les deux se combinent bien. Karpathy a lui-même ajouté un petit moteur de recherche sur le wiki, que l’agent pouvait appeler en ligne de commande pour les requêtes plus vastes, et le gist recommande qmd, un moteur de recherche local pour fichiers markdown sous licence MIT, avec recherche par mots-clés, vectorielle et hybride, plus un reclassement par modèle, le tout tournant sur votre machine et disponible à la fois en outil de ligne de commande et en serveur MCP. C’est du RAG appliqué à un wiki : la récupération trouve les pages, et les pages portent la synthèse. Une troisième option, coller tout le contenu dans une très longue fenêtre de contexte, est traitée dans notre article sur les fenêtres de contexte d’un million de tokens (en anglais) ; elle fonctionne un temps, puis devient chère et lente.
Ce qu’il faut avant de commencer
Élément
Son rôle
Coût en novembre 2026
Obsidian
L’éditeur dans lequel vous lisez et parcourez le wiki : liens, rétroliens, vue graphique
Gratuit pour un usage personnel et professionnel, sans compte. L’option Sync coûte 4 $ par mois en facturation annuelle ou 5 $ en facturation mensuelle (en dollars US), d’après la page des tarifs d’Obsidian.
Obsidian Web Clipper
Une extension de navigateur qui enregistre des pages web dans votre coffre
Gratuit ; la page du Web Clipper indique que le code est open source et que l’extension ne collecte ni données ni statistiques d’utilisation.
Claude Code
L’agent qui lit les sources et rédige les pages
Nécessite une offre payante. Pro coûte 20 $ par mois, ou 17 $ par mois en facturation annuelle (200 $ payés d’avance) ; Max coûte 100 $ par mois ; Ultra coûte 200 $ par mois (en dollars US), d’après les tarifs de Claude. L’offre gratuite de Claude n’inclut pas Claude Code. L’autre option est la facturation de l’API au token.
git
L’historique des versions, pour que chaque modification de l’agent puisse être relue et annulée
Gratuit et facultatif, mais vivement recommandé.
qmd ou un autre outil de recherche
La recherche, une fois que le wiki dépasse ce que son index permet
Gratuit et facultatif ; vous n’en aurez pas besoin pour la première centaine de sources environ.
Prix relevés sur la page de tarifs officielle de chaque outil en novembre 2026. Des taxes peuvent s’appliquer.
La page d’installation d’Anthropic indique macOS 13 ou version ultérieure, Windows 10 ou version ultérieure et les versions récentes d’Ubuntu et de Debian, au moins 4 Go de RAM et une connexion internet. Cette connexion compte : l’agent tourne sur votre ordinateur, mais le modèle avec lequel il communique tourne dans le cloud d’Anthropic, donc rien de tout cela ne fonctionne hors ligne.
Claude Code n’est pas le seul choix possible. Le gist de Karpathy cite aussi Codex d’OpenAI et OpenCode, et tout ce qui suit s’y transpose avec un fichier AGENTS.md à la place de CLAUDE.md.
Côté consommation, mieux vaut être réaliste. Les abonnements incluent l’usage de Claude Code jusqu’à une certaine limite, et l’API est facturée au token. La documentation d’Anthropic sur les coûts indique que la consommation de tokens augmente avec la taille du contexte, donne une moyenne en entreprise d’environ 13 $ par développeur et par jour d’activité pour du travail de programmation, et conseille de vider la session entre deux tâches sans rapport. Un wiki n’est pas une base de code : voyez dans ce chiffre le signe que les longues sessions d’agent finissent par coûter, pas une prévision. La commande /usage, dans Claude Code, montre quelle part de votre offre une session consomme.
La mise en place, étape par étape
Voici une configuration complète et minimale de second cerveau Claude avec Obsidian. Comptez une soirée, passée surtout à écrire le schéma et à lire les premières pages produites par l’agent.
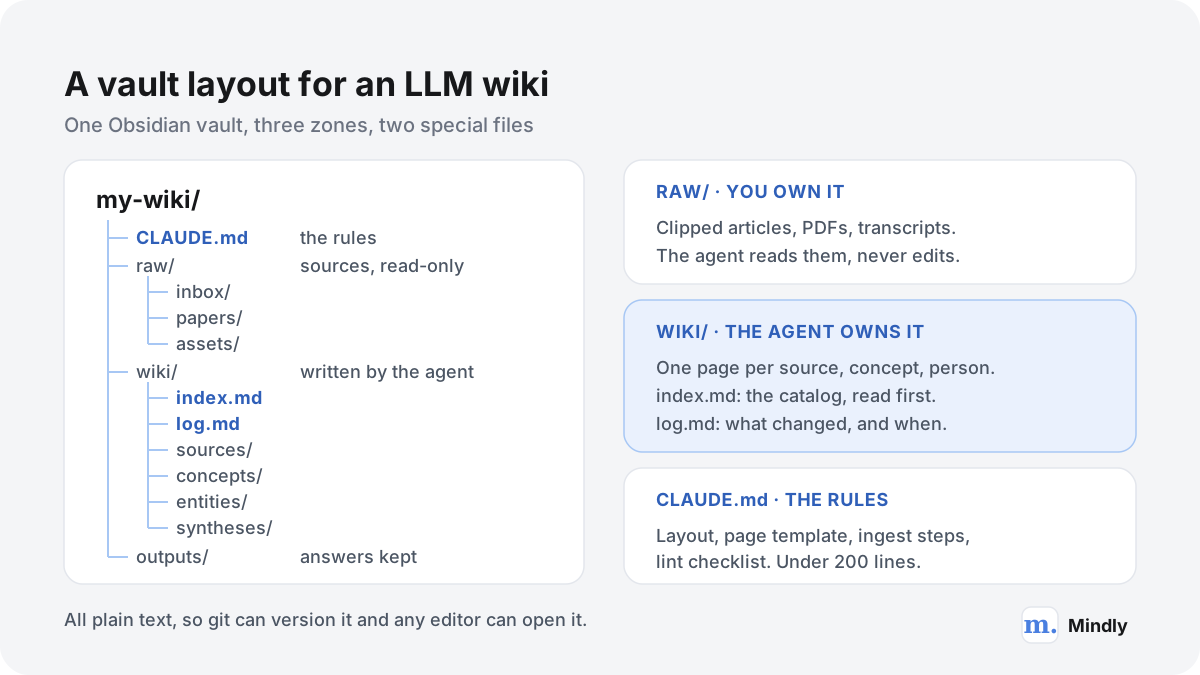
Créer le dossier. Créez un dossier nommé my-wiki avec quatre sous-dossiers : raw (qui contient inbox, papers et assets), wiki et outputs. Gardez-le hors d’iCloud Drive, de Dropbox ou de tout dossier partagé tant que vous n’avez pas décidé de ce que vous y mettrez.
L’ouvrir comme coffre. Dans Obsidian, choisissez d’ouvrir un dossier comme coffre et sélectionnez my-wiki. Obsidian ajoute son propre dossier de réglages caché, .obsidian, et laisse pour le reste vos fichiers tels quels.
Garder les images en local. Une astuce de Karpathy : dans Obsidian, sous Paramètres > Fichiers et liens, indiquez raw/assets comme dossier des pièces jointes, puis, sous Paramètres > Raccourcis clavier, cherchez la commande « Download attachments for current file » (télécharger les pièces jointes du fichier actuel) et attribuez-lui un raccourci. Après avoir enregistré un article, utilisez-le : les images sont sauvegardées sur le disque, et l’agent peut les examiner au lieu de liens susceptibles de ne plus fonctionner.
Installer le Web Clipper. Ajoutez l’Obsidian Web Clipper à votre navigateur et choisissez raw/inbox comme dossier d’enregistrement. Dès lors, n’importe quel article devient en deux clics un fichier markdown dans votre dossier inbox.
Installer Claude Code. Sur Mac, ouvrez Terminal et lancez la commande d’installation indiquée sur la page d’installation d’Anthropic : curl -fsSL https://claude.ai/install.sh | bash. Ouvrez une nouvelle fenêtre de terminal et lancez claude --version pour vérifier que l’installation a fonctionné.
Placer le coffre sous gestion de versions. Dans le terminal, placez-vous dans le dossier (cd suivi de son chemin), lancez git init, puis faites un premier commit. Le gist fait remarquer que le wiki n’est qu’un dépôt git de fichiers markdown, ce qui vous offre d’emblée l’historique et l’annulation.
Lancer l’agent dans le coffre. Lancez claude depuis le dossier et connectez-vous quand on vous le demande. Restez dans le mode par défaut, qui demande confirmation avant chaque modification et chaque commande, tant que les procédures n’ont pas gagné votre confiance. Appuyez sur Shift+Tab pour passer en mode plan (plan mode) quand vous voulez que l’agent fasse des propositions avant de toucher à quoi que ce soit.
Écrire le schéma. Collez le gist de Karpathy dans la session, décrivez votre sujet en deux ou trois phrases et demandez à l’agent de rédiger un CLAUDE.md pour ce coffre. Retouchez ensuite ce brouillon vous-même, en vous servant du modèle ci-dessous comme liste de contrôle. Faites court.
Intégrer une source et relire tout ce qu’elle a touché. Enregistrez un article que vous connaissez bien, demandez à l’agent de l’intégrer et ouvrez chaque page qu’il a créée ou modifiée. Vous vérifiez les conventions autant que le contenu : noms des pages, style des liens, références, ligne d’index.
Corriger le schéma, faire un commit, recommencer. Chaque correction que vous faites à la main doit devenir une règle. Après cinq à dix sources, la procédure se stabilise en général.
Un coffre, trois zones. Tout est en texte brut : n’importe quel éditeur peut le lire, et git aussi.
Un CLAUDE.md pour démarrer
Voici un schéma de départ, rédigé section par section tel qu’il apparaîtrait dans le fichier. Remplacez le sujet, supprimez ce dont vous n’avez pas besoin, et gardez l’ensemble bien en dessous des 200 lignes qu’Anthropic recommande pour un CLAUDE.md.
Objectif. Ce coffre est un wiki de recherche sur [votre sujet]. Je choisis les sources dans raw/. Tu rédiges et entretiens tout ce qui se trouve dans wiki/. Ton rôle est l’intendance : résumer, relier, classer et signaler, pas décider de ce qui est vrai.
Arborescence. raw/ est en lecture seule : n’y modifie, n’y renomme et n’y supprime jamais rien. wiki/sources/ contient une page par source, qui porte son nom. wiki/concepts/ regroupe les idées et les méthodes, wiki/entities/ les personnes, les organisations et les jeux de données, wiki/syntheses/ les réponses et les comparaisons que je te demande de conserver. wiki/index.md et wiki/log.md sont décrits plus bas. outputs/ contient les diaporamas et les graphiques.
Format des pages. Chaque page commence par des propriétés : type, sources (un nombre), updated (une date). Utilise des [[wikilinks]] pour chaque mention d’une page existante. Chaque phrase factuelle se termine par un lien vers la page de la source dont elle provient. Quand des sources se contredisent, les pages comportent une section intitulée Désaccords.
Index et journal. index.md liste chaque page par catégorie, avec un lien et une ligne de résumé ; mets-le à jour à chaque changement. log.md ne se modifie que par ajout ; chaque entrée commence par ## [AAAA-MM-JJ], suivi du mot ingest, query ou lint, d’une barre verticale et d’un titre.
Répondre aux questions. Lis d’abord index.md, puis les pages dont tu as besoin. Réponds uniquement à partir du wiki et cite les pages utilisées. Si le wiki ne contient pas la réponse, dis-le et suggère quelle source intégrer. Propose d’enregistrer les réponses utiles dans wiki/syntheses/.
Jamais. N’invente jamais de référence ni de source. Ne supprime jamais de page ; marque-la comme obsolète et ajoute un lien vers celle qui la remplace. Ne lance jamais de recherche web et ne récupère jamais de page sans demander d’abord. Ne touche jamais aux fichiers situés hors de ce dossier.
Remarquez ce qui n’y figure pas : les procédures d’ingestion et de lint détaillées étape par étape. Elles sont longues et ne servent que lorsque vous les lancez, elles ont donc leur place dans des skills, présentés juste après. Savoir écrire pour un modèle est un savoir-faire à part entière ; notre guide sur les notes qu’une IA peut vraiment lire (en anglais) traite de ce versant rédactionnel.
La procédure d’ingestion
C’est à l’ingestion que le wiki se construit ou se gâche. Pendant les premières semaines, une bonne procédure est lente à dessein.
Déposer la source dans raw/inbox. Un article enregistré, un PDF, une transcription, une page de vos propres notes. Un fichier par source.
Lancer la procédure. Tapez /ingest suivi du nom du fichier. L’agent lit le schéma, l’index et la source.
En discuter avant d’écrire. L’agent liste les cinq points les plus importants et les pages existantes qu’il compte modifier, puis vous demande sur quoi insister. C’est l’étape où Karpathy passe en revue avec le modèle ce qu’il faut retenir, et c’est là que vous repérez un contresens avant qu’il se propage.
Rédiger la page de la source. Un résumé dans wiki/sources/, avec les affirmations clés, les méthodes, les limites que reconnaissent les auteurs eux-mêmes et un lien vers le fichier brut.
Mettre à jour concepts et entités. De nouveaux paragraphes sur les pages existantes, de nouvelles pages quand un concept apparaît pour la deuxième fois, et chaque phrase reliée à la page de la source.
Signaler les conflits. Quand la source contredit une page, une courte entrée est ajoutée dans la section Désaccords des deux pages, en nommant les deux sources.
Mettre à jour l’index et le journal. Une ligne par nouvelle page dans index.md, une entrée dans log.md qui liste toutes les pages touchées.
Relire et faire un commit. L’agent donne la liste des fichiers modifiés. Vous les lisez, vérifiez le diff git et faites un commit avec le titre de la source comme message. Ensuite, vous déplacez vous-même le fichier de raw/inbox vers son dossier définitif.
En faire une commande
Dans Claude Code, une procédure que vous lancez souvent devient un skill : un dossier placé dans .claude/skills, à l’intérieur du coffre, qui contient un fichier SKILL.md. Ce fichier commence par une courte description, dont Claude se sert pour décider quand le skill s’applique, suivie des étapes ci-dessus rédigées sous forme d’instructions. Un skill rangé dans un dossier nommé ingest se lance en tapant /ingest, et il ne se charge que lorsqu’on l’appelle, ce qui allège d’autant le CLAUDE.md, chargé, lui, en permanence. Créez-en un second pour le lint. Les anciens fichiers de commandes personnalisées placés dans .claude/commands fonctionnent toujours, mais les skills sont le format qu’Anthropic recommande pour tout nouveau travail.
Une page de source type (exemple fictif)
sources/2026-03 Étude de terrain sur la canopée urbaine
Type : source. Fichier brut : raw/papers/canopy-field-study.pdf. Résumé : une étude de terrain menée en été qui compare la température des rues situées sous la canopée des arbres à celle de rues voisines sans ombre, dans une seule ville. Affirmations clés : les rues ombragées sont plus fraîches au niveau de la chaussée l’après-midi ; l’effet est le plus marqué lors des journées les plus chaudes. Méthode : relevés de température de surface, et non de température de l’air, ce qui importe dès qu’on la compare à d’autres sources. Limites reconnues par les auteurs : une seule ville, un seul été. Désaccords : rapporte un effet plus important que [[sources/2025-11 Modèle régional de température de l’air]] ; probablement dû à la différence de mesure, voir [[concepts/Température de surface vs température de l’air]].
Pages touchées à l’ingestion : concepts/Arbres d’alignement et chaleur · concepts/Température de surface vs température de l’air · entities/Service des espaces verts de la ville · index.md · log.md
Poser des questions, reverser les réponses et le lint hebdomadaire
Une fois que quelques dizaines de sources y sont entrées, le wiki commence à rapporter : les questions trouvent leur réponse dans des pages qui relient déjà vos lectures, et un contrôle régulier garde ces pages honnêtes.
Poser une question, c’est simplement converser avec l’agent dans le coffre. Il lit l’index, ouvre les pages pertinentes et rédige une réponse qui les cite. Les questions qui marchent le mieux sont celles auxquelles un champ de recherche ne sait pas répondre : sur quoi mes sources s’accordent-elles, où divergent-elles et pourquoi, quelle affirmation repose sur une seule source, qu’est-ce qui a changé dans ma compréhension depuis mars. Karpathy préfère des réponses sous forme de fichiers plutôt que de texte dans le terminal : pages markdown, diaporamas au format Marp ou graphiques tracés avec matplotlib, qui s’ouvrent tous dans Obsidian. Si vos pages portent des propriétés comme des dates et des nombres de sources, le plugin Dataview, que le gist mentionne aussi, peut les transformer en tableaux dynamiques.
L’étape qui fait fructifier le système, c’est de reverser les bonnes réponses au wiki. Une comparaison dont vous aurez de nouveau besoin va dans wiki/syntheses, avec des liens vers chaque page dont elle s’est servie, et reçoit une ligne dans l’index et une entrée dans le journal. Une règle compte ici plus que toutes les autres : l’agent doit dire quand le wiki ne contient pas la réponse. Sinon, il comble le vide avec les connaissances générales du modèle, et une réponse sans source est reversée au wiki comme si elle venait de vos lectures.
Une page de synthèse reversée au wiki (exemple fictif)
syntheses/Les arbres d’alignement rafraîchissent-ils assez les villes pour que cela compte
Question posée : 2026-04-21. Réponse courte : sur 14 sources, l’ombre abaisse de façon constante la température de surface au niveau de la rue ; les effets sur la température de l’air sont plus faibles et varient selon la forme urbaine. Preuves les plus solides : [[sources/2026-03 Étude de terrain sur la canopée urbaine]], [[sources/2025-08 Comparaison satellitaire entre plusieurs villes]]. Maillon le plus faible : les chiffres coûts-bénéfices reposent sur un seul rapport, [[sources/2024 Revue budgétaire du conseil municipal]]. Question ouverte : aucune source ne traite des effets nocturnes. Prochaine source suggérée : une étude qui mesure la température de l’air la nuit.
Construite à partir de : 9 pages de sources · 3 pages de concepts
Le lint hebdomadaire
Le lint est un bilan de santé que vous lancez avec un second skill, environ une fois par semaine ou après toute ingestion par lots. Demandez d’abord à l’agent un simple rapport, sans rien modifier, puis décidez quelles corrections accepter.
Contradictions. Des pages qui affirment des choses incompatibles, surtout quand aucune entrée Désaccords n’existe encore.
Affirmations périmées. Des énoncés qu’une source plus récente a dépassés et qui figurent encore sur des pages de concepts ou de synthèse.
Pages orphelines. Des pages vers lesquelles aucune autre page ne pointe. La vue graphique d’Obsidian représente les notes par des cercles et les liens par des traits, et propose une option pour afficher les orphelines, ce qui les rend faciles à repérer.
Pages manquantes. Des concepts mentionnés sur plusieurs pages qui n’ont pas de page à eux.
Liens manquants. Des mentions de pages existantes écrites en texte simple plutôt que sous forme de liens.
Phrases sans source. Des phrases factuelles sans lien vers une page de source. C’est le point le plus important de la liste.
Index mal tenu. Des entrées d’index qui pointent vers des pages qui n’existent plus, et des pages absentes de l’index.
Lacunes. Des questions ouvertes auxquelles une nouvelle source pourrait répondre. Karpathy utilise ici la recherche web pour compléter les données manquantes ; subordonnez-la à votre accord explicite.
Un rapport de lint (exemple fictif)
## [2026-04-26] lint | Bilan de santé semaine 4
2 contradictions : concepts/Arbres d’alignement et chaleur dit que les effets sont « les plus forts à midi », sources/2026-03 dit « l’après-midi » ; la synthèse cite les deux. 1 affirmation périmée : la vue d’ensemble donne encore le chiffre de plantations de 2024, remplacé par le rapport municipal de 2026. 3 orphelines : entities/Prestataire des relevés, concepts/Albédo, sources/2025 Podcast épisode 41. 4 phrases sans source sur concepts/Îlot de chaleur urbain. 1 page manquante : « taille des fosses de plantation », mentionnée sur 4 pages. Aucune modification effectuée. Indiquer les numéros à corriger.
Ensuite : corriger d’abord les phrases sans source · relancer le lint après
Les signes de dérive sont faciles à repérer quand on les cherche : l’index et le dossier ne s’accordent pas sur le nombre de pages, un même concept a deux pages aux noms légèrement différents, les pages de synthèse ne sont plus mises à jour après les nouvelles ingestions, ou vous vous surprenez à fouiller le dossier des sources brutes parce que vous ne faites plus confiance au wiki. Chacun de ces signes justifie une passe de lint et une retouche du schéma, pas un nouveau départ.
Un exemple détaillé : 30 sources en un mois
Un cas d’illustration, avec des sources inventées : un analyste dispose de quatre semaines pour expliquer à un conseil municipal si planter des arbres d’alignement contre la chaleur estivale vaut la dépense.
La liste de lecture compte 30 sources : 20 publications scientifiques, 6 rapports de la ville et d’agences publiques, et 4 conférences enregistrées, conservées sous forme de transcriptions. L’analyste monte le coffre un lundi soir, écrit le schéma et intègre la première source le mardi. Les chiffres du tableau correspondent à ce qu’une procédure soigneuse pourrait produire dans cet exemple ; ce ne sont pas des mesures.
Semaine
Ce qui se passe
Le wiki en fin de semaine
1
Mise en place, schéma, 6 sources intégrées une par une. Le schéma est retouché après presque chaque ingestion : noms des pages, format des références, nouvelle règle pour distinguer température de surface et température de l’air.
6 pages de sources, 9 pages de concepts, 4 pages d’entités, l’index et le journal
2
10 sources de plus, toujours une par une, environ 20 minutes chacune en comptant la lecture des pages modifiées. Les premières entrées Désaccords apparaissent.
16 pages de sources, 17 concepts, 8 entités
3
Les 4 transcriptions sont intégrées par lot, puis 10 publications de plus une par une. La première passe de lint trouve 3 pages orphelines et 6 phrases sans source.
30 pages de sources, 24 concepts, 11 entités
4
Des questions plutôt que des ingestions : 5 réponses reversées sous forme de pages de synthèse, un diaporama Marp pour le conseil, une deuxième passe de lint.
Environ 75 pages, 5 synthèses, 1 diaporama dans outputs/
Chiffres fictifs. Les nombres réels dépendent entièrement du sujet et du schéma.
Une page de concept après la semaine 3 (exemple fictif)
concepts/Température de surface vs température de l’air
Beaucoup de sources mesurent à quel point le sol et les murs chauffent (température de surface) ; moins nombreuses sont celles qui mesurent l’air que l’on respire (température de l’air). À l’ombre, les écarts de surface sont systématiquement plus importants que les écarts de température de l’air [[sources/2026-03 Étude de terrain sur la canopée urbaine]] [[sources/2025-08 Comparaison satellitaire entre plusieurs villes]]. Désaccords : le modèle régional de [[sources/2025-11 Modèle régional de température de l’air]] trouve de faibles effets sur la température de l’air et il est souvent cité comme contredisant l’étude de terrain ; les deux ne mesurent pas la même chose. Pourquoi c’est important pour la note au conseil : les affirmations sur le confort et la santé demandent la température de l’air ou la température ressentie, pas des relevés de surface.
Pages qui y renvoient : 11 · Sources : 7
Les dernières lignes du journal (exemple fictif)
wiki/log.md
## [2026-04-24] ingest | Revue budgétaire du conseil municipal 2024 (6 pages touchées). ## [2026-04-25] query | Quels coûts reposent sur une seule source ? (classée dans syntheses/Cartographie des preuves sur les coûts). ## [2026-04-26] lint | Bilan de santé semaine 4 (14 problèmes, 11 corrigés). ## [2026-04-27] query | Projet de diaporama pour le conseil (outputs/council-briefing.md).
Dans cet exemple, ce qui a fait la différence, ce n’est pas l’intelligence du modèle, mais trois habitudes : relire chaque page modifiée pendant les deux premières semaines, la règle qui impose une source à chaque phrase, et l’inscription dans le schéma de la distinction entre surface et air dès la première fois qu’elle a semé la confusion. Le coût, c’est du temps, surtout de lecture, et un mois de sessions d’agent sur une offre payante. Le gain, c’est une note au conseil dont chaque affirmation peut être rattachée à une page et chaque page à une source, et un wiki que l’analyste pourra rouvrir l’été suivant.
Une variante plus légère convient à une année de lecture plutôt qu’à un projet de recherche. Intégrez les passages surlignés de chaque livre et vos propres notes quand vous le terminez, une source par livre, et laissez le modèle entretenir des pages pour les idées, les auteurs et les arguments qui reviennent. Au bout de 20 livres, vous avez une carte de ce que vous avez lu et de la manière dont tout se relie, c’est-à-dire ce que notre guide pour retenir ce que vous lisez (en anglais) cherche à obtenir à la main.
Risques et limites
L’approche est utile, et elle est récente. La plupart de ses problèmes ont la même origine que sa force : c’est un modèle qui écrit votre base de connaissances.
Des erreurs qui s’accumulent
Dans un système RAG, une mauvaise réponse reste en général un incident isolé. Dans un wiki, un résumé erroné devient une page, l’ingestion suivante pointe vers elle, une synthèse la cite, et un an plus tard elle se lit comme un fait établi. Les liens hallucinés en sont la version visible : un lien vers une page ou une source qui n’existe pas. Les affirmations inventées ou déformées en sont la version dangereuse. Les parades sont celles de ce guide : des sources jamais modifiées, une référence sur chaque phrase factuelle, une passe de lint qui liste les phrases sans source, et l’historique git pour voir quand une affirmation est apparue. Aucune ne dispense de lire. L’auteur de R&D World, après un mois avec un wiki d’environ 760 pages, jugeait toujours la vérification manuelle des faits nécessaire, et décrivait le risque d’hallucination comme réduit, pas éliminé.
Confidentialité : vos fichiers partent chez un fournisseur de modèles
Claude Code tourne sur votre ordinateur, mais pour faire quoi que ce soit, il envoie à Anthropic, via une connexion chiffrée, vos prompts et les réponses du modèle, y compris le contenu des fichiers qu’il lit pour faire le travail. La page d’Anthropic sur l’utilisation des données indique que sur les offres grand public (gratuite, Pro, Max et Ultra), vous choisissez si vos données peuvent servir à améliorer les futurs modèles, avec une durée de conservation de 5 ans si vous l’autorisez et de 30 jours sinon, et que les offres professionnelles et l’API ne servent pas à l’entraînement par défaut. Claude Code conserve aussi les transcriptions des sessions en texte brut sur votre propre machine, pendant 30 jours par défaut. Vérifiez ce réglage avant d’intégrer quoi que ce soit de personnel, et réfléchissez-y à deux fois pour tout document médical, juridique ou client. Connecter davantage d’outils au même agent fait monter les enjeux ; nous expliquons pourquoi dans les fuites de données MCP, quand les agents connectent tout (en anglais), et abordons la question plus large de savoir qui détient votre contexte dans la guerre de la mémoire IA (en anglais).
Coûts et limites d’usage
Chaque ingestion lit une source et réécrit plusieurs pages, et chaque question lit l’index et une poignée de pages : un wiki qui grandit consomme donc plus de tokens par opération. Avec un abonnement, cela se traduit par des limites d’usage atteintes plus tôt ; avec l’API, cela se voit sur la facture. Selon les conseils d’Anthropic sur les coûts, il est utile de vider la session entre deux ingestions, de garder un schéma court et d’utiliser un modèle moins cher pour les passes de routine. Un modèle local évite à la fois la facture et la question de la confidentialité, au prix de résultats aujourd’hui moins bons ; notre article sur l’IA locale sur votre ordinateur portable (en anglais) passe en revue ce qui tourne bien.
Entretien et dérive
La promesse du gist, c’est que l’entretien devient presque gratuit. En pratique, il devient peu coûteux, mais pas automatique. Le wiki ne change que lorsque vous lancez une ingestion ou un lint, et le schéma doit être retouché à mesure que le sujet s’étend. Le compte rendu de R&D World a constaté que le wiki ne se mettait pas à jour tout seul par défaut, que la surveillance automatisée n’était qu’en partie en place, et que pour des sujets bien couverts sur le web ouvert, l’effort n’en valait peut-être pas la peine. Son verdict, modérément utile et prometteur pour des cas bien délimités, correspond à la conception même de l’approche : un seul sujet, des sources choisies, un humain dans la boucle.
Échelle et dépendance
Selon l’estimation de Karpathy, l’approche fondée sur le seul index reste confortable jusqu’à une centaine de sources et quelques centaines de pages. Au-delà, l’agent a besoin d’une recherche, et vous finissez par faire tourner un système RAG sur votre wiki, ce qui ne pose pas de problème mais n’a plus rien de simple. La dépendance à l’outil, en revanche, est faible : tout est en markdown dans un dossier, lisible par n’importe quel éditeur, le genre de format qui survit aux applications qui l’entourent (en anglais). Si vous cessez d’utiliser l’agent, vous gardez les pages.
Le lien avec les méthodes classiques
Le LLM wiki emprunte sa forme à des méthodes de prise de notes plus anciennes et n’y change qu’une chose : qui écrit.
Son ancêtre le plus proche est le Zettelkasten, la boîte à fiches du sociologue Niklas Luhmann, qui a rédigé environ 90 000 fiches entre 1951 et 1996, selon les archives Luhmann de l’université de Bielefeld. Des notes courtes, chacune reliée à d’autres, avec un index qui donne accès à l’ensemble : c’est presque exactement la structure du wiki. La différence tient au but même de la méthode. Luhmann écrivait chaque fiche lui-même, avec ses propres mots, et c’est dans l’écriture que se faisait la réflexion. Dans un LLM wiki, c’est le modèle qui écrit les notes : vous obtenez la structure sans la réflexion, à moins de réfléchir ailleurs, dans les questions que vous posez et les synthèses que vous contestez.
Des dossiers classés du plus actionnable au moins actionnable ; une méthode qui va de la capture à l’expression
Le wiki forme une seule Ressource de recherche ; l’étape Exprimer prend la forme des réponses reversées au wiki
La structure est familière. Ce qui est nouveau, c’est qu’un modèle se charge du classement et des liens.
Les notes evergreen, en particulier, sont le meilleur exemple de ce à quoi doit ressembler une bonne page de concept : un titre formulé comme une affirmation ou un concept, un texte qui se lit sans avoir la source sous les yeux, et des mises à jour plutôt que des doublons. Demander à l’agent d’écrire ses pages de concepts de cette façon est l’une des lignes les plus utiles qu’un schéma puisse contenir. Un wiki que vous publiez, comme l’auteur de R&D World l’a fait pour une partie du sien, devient un digital garden (jardin numérique) entretenu par un jardinier qui ne dort jamais, ce qui relève encore l’exigence en matière de références, puisque des inconnus le liront.
Comment fonctionne la boîte à fiches de Luhmann, et comment en commencer une à la main : La méthode Zettelkasten →
Si vous ne voulez pas de terminal
Beaucoup de gens veulent le résultat, un second cerveau qui s’organise tout seul, sans avoir à superviser un agent en ligne de commande. Il existe des solutions honnêtes, chacune avec ses compromis.
Solution
Ce que vous obtenez
Ce à quoi vous renoncez
Claude Code dans l’application de bureau d’Anthropic
Le même agent et la même approche, pilotés depuis une fenêtre plutôt que depuis un terminal
Le terminal, et rien d’autre : c’est toujours un agent qui modifie vos fichiers sous votre supervision, avec une offre payante
Un outil RAG comme NotebookLM
Importer des sources et discuter avec elles en quelques minutes
Rien ne s’accumule d’une question à l’autre ; aucune page qui vous appartienne ni que vous puissiez modifier
Une application qui organise automatiquement, comme Mindly
Étiquettes, résumés, connexions et recherche en langage naturel sur tout ce que vous enregistrez, sans configuration
Pas de pages de wiki compilées, et aucun accès d’agent à la bibliothèque
Un assistant conversationnel et Obsidian, à la main
Coller une source, demander une page de résumé, la coller dans un coffre
C’est vous qui faites l’intendance que l’approche devait prendre en charge
Un résumé des compromis décrits dans ce guide, en novembre 2026.
La solution de l’application de bureau est celle qui garde l’approche intacte, et la page d’installation d’Anthropic oriente vers cette application les personnes qui préfèrent une interface graphique. La solution RAG est la plus rapide à démarrer et la plus faible en synthèse, comme le montre la comparaison plus haut ; nous passons en revue les options dans alternatives à NotebookLM (en anglais) et l’approche générale dans comment discuter avec vos documents (en anglais). La solution de l’organisation automatique est la plus éloignée de l’idée de Karpathy et la plus proche de ce que beaucoup entendent par second cerveau (en anglais) ou base de connaissances personnelle (en anglais) : vous continuez à enregistrer, et l’outil se charge de garder tout cela facile à retrouver.
La place de Mindly
Où Mindly a sa place, et où il ne l’a pas
Mindly n’est pas un LLM wiki, et il serait trompeur de le présenter comme tel. Il ne compile pas vos éléments enregistrés en pages de wiki reliées entre elles, et il ne permet ni à Claude Code ni à aucun autre agent de lire ou d’écrire dans sa bibliothèque : il n’y a ni serveur MCP ni API. Si c’est l’approche de Karpathy elle-même qui vous intéresse, la configuration Claude Code et Obsidian décrite plus haut est la bonne façon de la construire, et notre comparaison avec Obsidian (en anglais) dit franchement ce qu’Obsidian fait mieux. Ce que Mindly couvre, c’est une partie plus modeste du même souhait : un endroit sur votre Mac où enregistrer ne demande qu’un raccourci clavier et où le rangement se fait sans schéma. Liens, PDF, notes, captures d’écran, mémos vocaux et vidéos YouTube sont étiquetés par sujet et résumés (en anglais) au moment où vous les enregistrez, les éléments liés ou oubliés refont surface sous forme de suggestions intelligentes (en anglais), la recherche fonctionne en langage naturel (en anglais) sur tous les formats, et vous pouvez discuter avec n’importe quel élément (en anglais) pour obtenir des réponses fondées sur vos propres contenus. La bibliothèque est stockée localement dans un dossier Mindly, et les requêtes d’IA passent par des canaux chiffrés sans que le contenu soit conservé ensuite sur les serveurs de Mindly. C’est une application réservée au Mac, pour macOS 14 ou version ultérieure, sans application iPhone pour l’instant. Certains voudront peut-être les deux : Mindly pour tout ce qu’ils croisent, sans effort, et un LLM wiki mené à la main pour le seul sujet qu’ils étudient en profondeur. Faire passer des contenus de l’un à l’autre se fait à la main, puisque Mindly n’offre aucun accès aux agents. L’offre gratuite accepte 25 éléments, de quoi voir si un rangement automatique suffit à vos besoins avant de construire un wiki.
Questions fréquentes
Questions fréquentes sur le LLM wiki
Qu’est-ce qu’un LLM wiki ?
Une base de connaissances personnelle qu’un agent IA rédige et entretient sous la forme d’un dossier de pages markdown reliées entre elles. Vous ajoutez des sources dans un dossier en lecture seule ; l’agent résume chacune d’elles, met à jour les pages des concepts et des personnes concernés, tient un index et un journal, répond aux questions à partir des pages et les vérifie régulièrement pour y repérer contradictions et lacunes. Andrej Karpathy a décrit cette approche en avril 2026.
Qu’est-ce que Karpathy a publié exactement, et quand ?
Deux choses. Le 2 avril 2026, il a publié « LLM Knowledge Bases » sur X, où il décrivait sa propre configuration : des sources dans un dossier raw, un wiki compilé par un LLM, Obsidian pour la consultation, et un wiki de recherche d’environ 100 articles et 400 000 mots. Le 4 avril, il a publié un « fichier d’idée » sous forme de gist GitHub intitulé « LLM Wiki », conçu pour être collé dans un agent comme Claude Code ou Codex afin qu’il vous en construise une version. Ni l’un ni l’autre n’est un logiciel ; tous deux décrivent une approche.
LLM wiki vs RAG : lequel est le meilleur ?
Aucun des deux dans l’absolu. Le RAG va chercher des fragments de vos documents au moment de la question et convient aux grandes collections qui évoluent, ainsi qu’à la recherche de passages précis. Un LLM wiki fait la lecture une seule fois, à l’ingestion, et stocke la synthèse sous forme de pages, ce qui convient à un sujet que vous étudierez pendant des mois et aux questions qui couvrent de nombreuses sources. Karpathy a constaté qu’un fichier d’index suffisait autour de 100 sources ; au-delà, la plupart des configurations ajoutent une recherche sur le wiki, ce qui combine les deux.
Comment mettre en place un second cerveau Claude avec Obsidian ?
Créez un dossier avec les sous-dossiers raw, wiki et outputs, et ouvrez-le comme coffre Obsidian. Installez l’Obsidian Web Clipper pour enregistrer des articles dans raw, installez Claude Code, placez le dossier sous git, lancez claude à l’intérieur, et rédigez un CLAUDE.md qui fixe l’arborescence, le format des pages et les règles. Intégrez ensuite une source, relisez chaque page qu’elle a touchée, corrigez les règles, et recommencez. Claude Code nécessite une offre Claude payante ; Obsidian est gratuit.
Faut-il Claude Code, ou un autre agent peut-il faire l’affaire ?
N’importe quel agent compétent capable de lire et d’écrire des fichiers convient. Le gist de Karpathy cite Codex d’OpenAI et OpenCode aux côtés de Claude Code. Le fichier de schéma change de nom (AGENTS.md est le plus courant), et Claude Code lit lui-même un AGENTS.md quand un dossier n’a pas de CLAUDE.md. Les simples assistants conversationnels sans accès aux fichiers ne peuvent qu’imiter l’approche, et c’est alors à vous de copier les pages dans un sens puis dans l’autre.
Combien coûte un LLM wiki à faire tourner ?
Obsidian est gratuit pour un usage personnel et professionnel. Claude Code nécessite une offre payante : en novembre 2026, Pro coûte 20 $ par mois, ou 17 $ par mois en facturation annuelle, et Max et Ultra coûtent 100 $ et 200 $ par mois, tous ces prix étant en dollars US ; l’offre gratuite de Claude ne l’inclut pas. La facturation de l’API au token est l’autre possibilité. Les sessions d’ingestion intensives entament davantage les limites d’une offre, car chaque source réécrit plusieurs pages.
Un LLM wiki est-il privé ?
Les fichiers restent sur votre ordinateur, mais l’agent envoie ce qu’il lit au fournisseur du modèle pour faire son travail. Sur les offres grand public de Claude, vous choisissez si vos données peuvent servir à améliorer les modèles ; Anthropic les conserve 5 ans si vous l’autorisez et 30 jours sinon. Les offres professionnelles et l’API ne servent pas à l’entraînement par défaut. Vérifiez ce réglage avant d’intégrer des documents personnels, médicaux, juridiques ou de clients.
Jusqu’à quelle taille un LLM wiki peut-il grandir ?
Karpathy indique que laisser l’agent naviguer via index.md fonctionne à une échelle moyenne, autour de 100 sources et quelques centaines de pages. Au-delà, l’agent a besoin d’une véritable recherche dans les pages, comme qmd, un moteur de recherche markdown local que recommande le gist. En pratique, la limite tient en général à votre temps pour relire les ingestions et les rapports de lint plutôt qu’au logiciel.
Peut-on construire un LLM wiki sans savoir coder ?
Pas besoin de programmer, mais la configuration habituelle demande un terminal et une certaine aisance pour superviser un agent. Claude Code fonctionne aussi dans l’application de bureau d’Anthropic, ce qui supprime le terminal mais pas la supervision. Si ce que vous voulez, c’est un rangement automatique plutôt qu’un wiki compilé, des applications comme Mindly étiquettent, résument et relient ce que vous enregistrez, et permettent d’y faire des recherches, sans configuration, même si Mindly ne construit pas de pages de wiki et ne donne pas aux agents accès à sa bibliothèque.
Sources
Sur quoi s’appuie cette page
LLM Knowledge Bases (post on X)Andrej Karpathy · 2026La description d’origine : dossier raw/, wiki compilé, Obsidian comme interface, environ 100 articles et 400 000 mots, réponses reversées au wiki, bilans de santé, idée de fine-tuning. Publié le 2 avril 2026.
LLM Wiki (GitHub gist)Andrej Karpathy · 2026Le fichier d’idée : trois couches, ingestion, interrogation et lint, index.md et log.md, astuces, et la comparaison avec le Memex. Créé le 4 avril 2026.
Is Karpathy's viral LLM wiki helpful? Mostly yesBrian Buntz, R&D World · 2026Le compte rendu d’un mois d’utilisation d’un wiki d’environ 760 pages : avantages, temps d’entretien et risque d’hallucination qui demeure.
How Claude remembers your projectAnthropicEmplacements de CLAUDE.md, la recommandation des 200 lignes, les imports et la prise en charge d’AGENTS.md.
Advanced setupAnthropicConfiguration requise, commande d’installation, offres qui incluent Claude Code, et l’application de bureau.
Manage costs effectivelyAnthropicComment la consommation de tokens augmente, la commande /usage et les moyens de la réduire.
Data usageAnthropicChoix concernant l’entraînement et durées de conservation selon l’offre, et ce que Claude Code envoie sur le réseau.
Plans and pricingAnthropicPrix des offres Pro, Max et Ultra en dollars US, et offres qui incluent Claude Code (vérifié en novembre 2026).
How Obsidian stores dataObsidianLes coffres comme dossiers locaux de fichiers Markdown en texte brut, que d’autres applications peuvent modifier.
Obsidian Web ClipperObsidianNavigateurs pris en charge, code open source et déclaration de confidentialité.
PricingObsidianGratuité pour un usage personnel et professionnel, prix de Sync et de Publish (vérifié en novembre 2026).
qmdGitHubLe moteur de recherche markdown local recommandé dans le gist : recherche par mots-clés, vectorielle et hybride, serveur MCP, licence MIT.
Montez le coffre, intégrez un article que vous connaissez bien et relisez chaque page que l’agent a touchée. Si vous voulez que vos éléments enregistrés soient organisés sans faire tourner d’agent, téléchargez Mindly et voyez ce qu’il fait de vos 25 prochains.
L’application n’est pour l’instant disponible qu’en anglais.