LLM wikiLLM wiki: un segundo cerebro que la IA escribe y mantiene en orden.
Una LLM wiki es una base de conocimiento personal que un agente de IA escribe y mantiene por ti. Tú dejas las fuentes en una carpeta; el modelo las compila en páginas markdown enlazadas entre sí, responde a tus preguntas a partir de esas páginas y las revisa en busca de errores. Andrej Karpathy describió el patrón en abril de 2026, y con él arrancó la ola de segundos cerebros con IA construidos con Claude Code y Obsidian. Aquí tienes lo que propuso, en qué se diferencia de RAG y una guía honesta para montar la tuya.
Creado por Andrej Karpathy, que describió el patrón en abril de 2026.
Una wiki LLM es una base de conocimiento personal que construye y mantiene un modelo de lenguaje grande, en lugar de escribirla tú. Reúnes en una carpeta fuentes como artículos, estudios, transcripciones y notas. Un agente de IA lee cada una e incorpora lo aprendido a un conjunto de páginas markdown enlazadas entre sí: un resumen de la fuente, páginas para las personas, ideas y términos que menciona, y cambios en todas las páginas existentes a las que afectan. La idea es de Andrej Karpathy, investigador y divulgador de IA que fue miembro fundador de OpenAI y más tarde director de IA en Tesla. Describió su propio sistema en una publicación en X titulada «LLM Knowledge Bases» el 2 de abril de 2026, y dos días después publicó el patrón como un gist de GitHub llamado «LLM Wiki». Cuando la gente habla del segundo cerebro de Karpathy, o de un segundo cerebro con IA hecho con Claude, se refiere a esas dos publicaciones.
El gist describe tres capas. Las fuentes en bruto son tus documentos escogidos, y se tratan como inmutables: el modelo las lee y nunca las edita, así que siguen siendo la fuente de verdad. La wiki es un directorio de archivos markdown escritos por el modelo: resúmenes, páginas de entidades, páginas de conceptos, comparaciones, una visión general y una síntesis que se va actualizando. Karpathy deja claro que esta capa pertenece al modelo. Tú la lees; el modelo la escribe. La tercera capa es el esquema, un documento como CLAUDE.md para Claude Code o AGENTS.md para Codex de OpenAI, que le explica al agente cómo está organizada la wiki y qué rutina seguir en cada tarea. Karpathy lo considera el archivo de configuración clave, la pieza que convierte un chatbot genérico en un mantenedor disciplinado, y cuenta con que lo vayas afinando junto con el modelo a medida que descubres qué necesita tu tema.
Sobre esas capas funcionan tres operaciones. Ingesta (ingest): dejas una fuente nueva en la carpeta raw y le pides al agente que la procese. El agente la lee, comenta contigo las ideas principales, escribe una página de resumen, actualiza el índice y las páginas de entidades y conceptos afectadas, y añade una línea a un registro (log). Karpathy calcula que una sola fuente puede tocar entre 10 y 15 páginas de la wiki, y dice que prefiere incorporarlas de una en una y seguir implicado. Consulta (query): haces preguntas, y el agente localiza las páginas relevantes, las lee y responde con citas, en forma de página, tabla, presentación o gráfico. Lint: de vez en cuando le pides que haga un chequeo de la wiki en busca de contradicciones entre páginas, afirmaciones que fuentes más recientes han dejado atrás, páginas huérfanas a las que nada enlaza, conceptos que merecen página propia y lagunas que una búsqueda web podría cubrir.
Lo que la distingue es el momento en que se hace el trabajo. La mayoría de las herramientas que responden a partir de tus documentos (Karpathy cita entre ellas NotebookLM y la subida de archivos a ChatGPT) recuperan fragmentos cuando preguntas y montan una respuesta desde cero cada vez. Nada se acumula. En una wiki LLM la síntesis se escribe una vez y después se mantiene al día, de modo que las referencias cruzadas y las contradicciones señaladas ya existen cuando preguntas. Cuando lo publicó, su wiki sobre un tema de investigación rondaba los 100 artículos y las 400.000 palabras. Escribió que había esperado necesitar un «RAG sofisticado», pero que a ese tamaño bastaban los archivos de índice que mantiene el propio modelo y unos resúmenes breves. Las buenas respuestas vuelven a la wiki como páginas nuevas, así que sus preguntas, como él mismo dijo, «se van sumando» en la base de conocimiento.
Se extendió deprisa. En noviembre de 2026 la publicación en X ya superaba los 22 millones de visualizaciones, y en cuestión de días aparecieron tutoriales en vídeo, plantillas de inicio y herramientas basadas en ella. Parte del atractivo está en cómo lo plantea el gist: Obsidian como el editor en el que navegas, el modelo como el programador y la wiki como la base de código que este mantiene. Pero el gist es abstracto a propósito. Describe un patrón, no un producto, y Karpathy cerraba su publicación diciendo que había hueco para un producto de verdad en lugar de su «colección improvisada de scripts». El resto de esta guía es una forma práctica de construir el patrón, con lo que suele salir mal. Si la idea general te resulta nueva, nuestra explicación sobre el segundo cerebro con IA (en inglés) te pone en contexto.
En el origen
Explicado en vídeo
Una configuración para principiantes, de la bóveda al primer lint, con Obsidian y Claude Code. Teacher’s Tech, abril de 2026.
Para quién es
Para quién es una wiki LLM
Quien investiga a fondo un solo tema
Es el caso para el que Karpathy lo creó: semanas o meses leyendo estudios, artículos e informes sobre una misma pregunta, con una tesis que evoluciona sobre la marcha. La wiki te da una página por cada estudio, una por cada método, conjunto de datos o persona que no deja de aparecer, y una página de síntesis que cambia cuando cambian las pruebas. El hábito más valioso aquí es señalar las contradicciones: cuando la fuente 23 contradice a la fuente 4, el modelo lo anota en ambas páginas en vez de confiar en que te acuerdes tú. El ejemplo práctico de más abajo sigue un mes de este tipo de lectura.
Quien lee libros largos o sigue cursos
El gist propone archivar cada capítulo de un libro a medida que lo lees y dejar que el modelo cree páginas para personajes, lugares, temas y tramas, de modo que al llegar a la última página tengas una wiki de acompañamiento, una versión personal de las wikis de fans que los voluntarios construyen durante años. Un curso funciona igual: una página por clase, una por concepto y un glosario que se mantiene al día solo. Si ya llevas un commonplace book (libro de lugares comunes), es el mismo instinto, pero con un amanuense al lado que se encarga de los índices.
Quien sigue la evolución de su propia vida
Karpathy menciona también usos personales (objetivos, salud, psicología, desarrollo personal): entradas de diario, artículos y notas de pódcast convertidos en una imagen estructurada de ti. Aquí es donde el patrón resulta más tentador y más delicado. Una wiki sobre tu salud o tus relaciones es una wiki que envías, página a página, a un proveedor de modelos. Lee la sección de riesgos de esta guía antes de meter en ella nada que no quieras ver almacenado en los servidores de otros, y mantén esa bóveda fuera de carpetas compartidas o sincronizadas.
Equipos pequeños cuyo conocimiento no mantiene nadie
El gist imagina también una wiki interna alimentada con hilos de chat, transcripciones de reuniones, documentos de proyecto y llamadas con clientes, con personas que revisan los cambios del modelo. La cobertura de VentureBeat recogía una respuesta según la cual toda empresa tiene una carpeta raw que nadie ha compilado nunca (Karpathy coincidió en que eso apuntaba a un nuevo tipo de producto), junto con la advertencia de un fundador: cuando el conocimiento informal de miles de empleados se contradice, el salto es mucho más difícil. Para cinco personas con una unidad compartida, el patrón es realista. Para una empresa, es un proyecto con responsables, permisos y revisión, no un script de fin de semana.
Los principios clave
Por qué funciona el patrón
Compilar una vez y mantenerlo al día
La tesis central del gist es que la wiki es un artefacto persistente cuyo valor se acumula. Leer y conectar una fuente se hace una sola vez, en la ingesta, y el resultado se guarda en forma de páginas en lugar de tirarse tras una única respuesta. Las preguntas posteriores parten de un trabajo ya hecho. Es lo contrario de una ventana de chat, donde cada conversación nueva empieza de cero, un límite que analizamos en por qué ChatGPT no es un segundo cerebro (en inglés).
Las fuentes no se tocan
La carpeta raw es de solo lectura para el modelo. Esa sola regla hace que todo el sistema sea auditable: cualquier página de la wiki se puede contrastar con el documento del que salió, y si la wiki se tuerce, puedes reconstruirla a partir de las fuentes. También es la razón por la que el patrón funciona con archivos de texto plano. Obsidian guarda las notas como archivos Markdown en una carpeta de tu propio disco y se actualiza cuando otro programa los modifica, así que el agente y tú podéis trabajar en la misma carpeta a la vez.
El esquema es la disciplina
Un modelo a su aire pondrá nombres incoherentes a las páginas, se olvidará del índice y resumirá de forma distinta cada vez. El archivo de esquema fija las convenciones por escrito, y el agente lo lee al comienzo de cada sesión. Claude Code carga automáticamente el CLAUDE.md de un proyecto, pero la documentación sobre memoria de Anthropic se cuida de aclarar que el archivo se trata como contexto, no como configuración de obligado cumplimiento: las reglas concretas y breves se siguen con más fiabilidad que las largas. La coherencia sale de las reglas escritas, no del modelo.
El papeleo es el verdadero cuello de botella
Karpathy explica que funciona porque la parte tediosa de una base de conocimiento no es leer ni pensar, sino el papeleo: actualizar referencias cruzadas, mantener los resúmenes al día, anotar contradicciones entre decenas de páginas. La gente abandona las wikis porque esa carga crece más deprisa que su valor. A un modelo no le aburre. Karpathy relaciona la idea con el Memex de Vannevar Bush, de 1945, un archivo privado de documentos unidos por rastros asociativos, y dice que lo que Bush no supo resolver fue quién se encargaría del mantenimiento.
Errores comunes
Dónde fallan las wikis LLM (y cómo solucionarlo)
Incorporar cien archivos de golpe el primer día
Es tentador señalarle al agente una carpeta llena de PDF y volver al cabo de una hora. El resultado es una wiki que nunca has leído, construida sobre convenciones que nunca has revisado, con cada error inicial copiado cien veces. Karpathy dice que la ingesta por lotes es posible con menos supervisión, pero que él prefiere una fuente cada vez, leyendo los resúmenes y marcando qué destacar. La solución: incorpora las diez primeras fuentes una por una, ajusta el esquema después de cada una y pasa a los lotes solo cuando las páginas tengan el aspecto que quieres.
Páginas sin procedencia
Una frase de la wiki sin enlace a una página de fuente es una frase que no puedes comprobar, y si es errónea, la siguiente ingesta puede construir sobre ella. Los resúmenes que escribe un modelo pueden contener afirmaciones que la fuente nunca hizo. La solución es una regla en el esquema según la cual cada frase que afirma un hecho termina con un enlace a la página de fuente de la que procede, más una comprobación en el lint que liste las frases sin cita.
Un esquema que acaba convertido en manual
Cada molestia se convierte en una regla nueva y, seis semanas después, CLAUDE.md tiene 600 líneas. Anthropic recomienda no pasar de 200 líneas por archivo CLAUDE.md, porque los archivos más largos consumen más contexto y se siguen peor. La solución: limita el esquema a la estructura, el formato de página y las reglas inamovibles, y lleva las rutinas largas, como la ingesta y el lint, a skills (habilidades), que solo se cargan cuando las invocas.
Dar al agente vía libre en la carpeta
Un agente que puede editarlo todo también puede sobrescribir una fuente, borrar una página o renombrar media bóveda. La solución son tres pequeños hábitos: empezar las sesiones en un modo de permisos que pida confirmación antes de editar hasta que confíes en la rutina, escribir «nunca edites raw/» en el esquema y tener la bóveda en git para que cada cambio se pueda revisar con un diff y deshacer.
Construir herramientas en lugar de leer
El patrón invita a trastear: búsqueda a medida, paneles, scripts, plugins. Es fácil pasarse un mes mejorando la máquina sin leer nunca las páginas que produce. El balance de un mes publicado en R&D World dejaba el tiempo dedicado a mantener la wiki y el tiempo ahorrado más o menos en tablas. La solución es añadir herramientas solo cuando falla una pregunta real, como hizo Karpathy con el pequeño buscador que escribió para que el agente pudiera abordar consultas más grandes.
La guía completa
Cómo montar una LLM wiki con Claude Code y Obsidian
Cómo funciona el ciclo
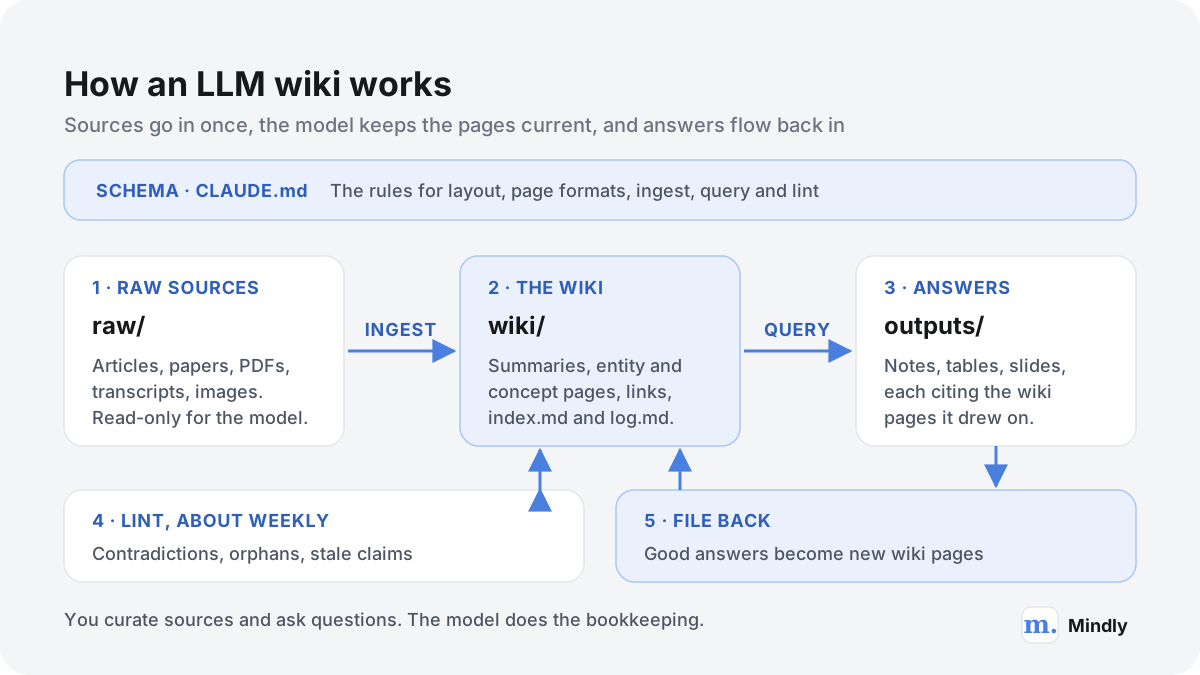
Toda wiki LLM sigue el mismo ciclo: entra una fuente, se actualizan las páginas, se responden preguntas, las buenas respuestas vuelven a archivarse y, de vez en cuando, se revisa el conjunto.
Las fuentes entran una sola vez. El modelo mantiene las páginas al día y tus preguntas vuelven a alimentarlas.
Veamos una ingesta concreta. Guardas en la carpeta raw un artículo sobre un estudio nuevo y le pides al agente que lo procese. El agente escribe una página de resumen del artículo. Detecta que el estudio usa un método que ya tiene página de concepto, así que añade allí un párrafo con un enlace de vuelta. El artículo menciona a dos investigadores; uno ya tiene página de entidad, que recibe también una línea, y el otro estrena página. El artículo contradice una afirmación de la página de síntesis, así que ambas páginas reciben una nota sobre la discrepancia. Después, el índice gana una línea y el registro una entrada. Son siete archivos modificados por un artículo corto. Karpathy calcula entre 10 y 15 páginas para una fuente típica, y es justo el tipo de trabajo que nadie sigue haciendo a mano.
Los dos archivos que lo sostienen todo
El gist menciona dos archivos especiales. index.md es el catálogo: todas las páginas de la wiki, agrupadas por categoría, con un enlace, un resumen de una línea y, si quieres, metadatos como una fecha o el número de fuentes en que se apoya cada una. El agente lo actualiza en cada ingesta y lo lee primero en cada pregunta; después abre solo las páginas que necesita. Karpathy cuenta que esto funciona bien a escala moderada, con unas 100 fuentes y unos pocos cientos de páginas, sin ninguna búsqueda por embeddings.
log.md es el historial: una lista a la que solo se añaden entradas y que recoge qué ha pasado y cuándo, ya sean ingestas, preguntas o pasadas de lint. Su consejo es empezar cada entrada con el mismo prefijo, por ejemplo «## [2026-04-02] ingest | Título del artículo», para que las herramientas habituales de línea de comandos puedan leerlo. Ejecutar grep "^## \[" log.md | tail -5 muestra las cinco últimas entradas. El registro también le dice al agente, al empezar una sesión nueva, qué ha hecho últimamente, algo importante porque, si no, cada sesión empieza con la memoria vacía.
LLM wiki frente a RAG
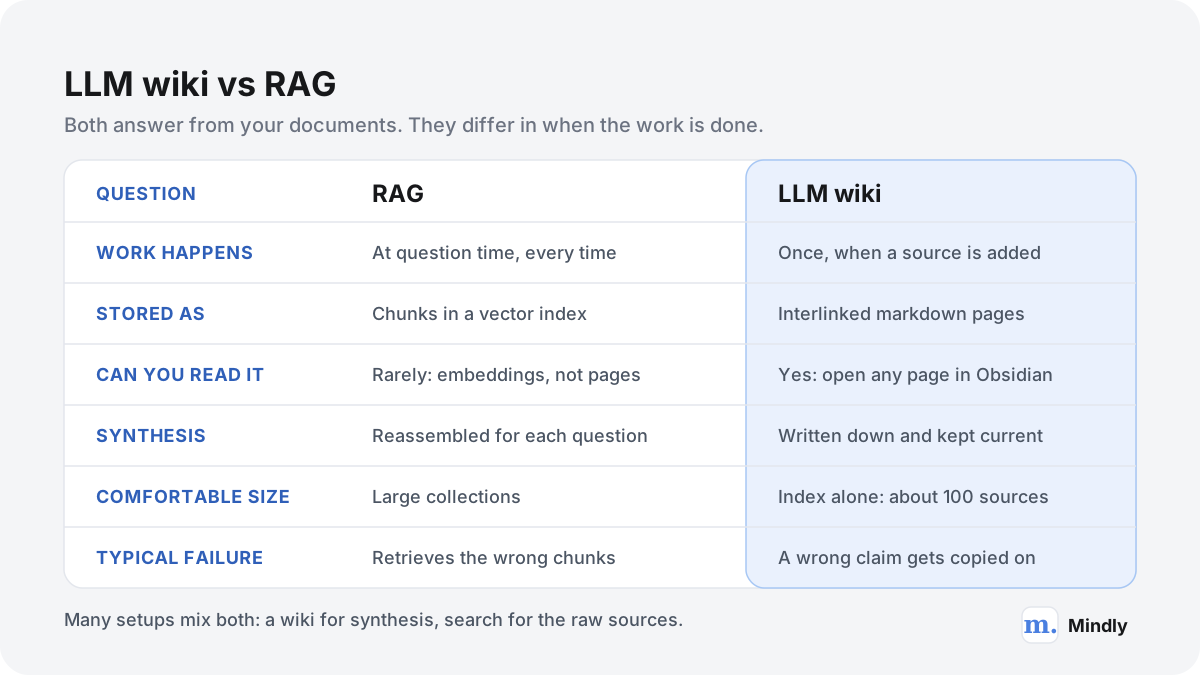
Los dos enfoques intentan resolver el mismo problema, sacar buenas respuestas de tus propios documentos, y se diferencian sobre todo en el momento en que el modelo hace el trabajo.
La generación aumentada por recuperación (RAG) recibió su nombre en un artículo de 2020 de Patrick Lewis y sus colegas, que combinaba el conocimiento integrado de un modelo de lenguaje con un recuperador que buscaba en un almacén externo, en su caso un índice vectorial denso de Wikipedia. En el uso corriente, RAG significa hoy esto: dividir los documentos en fragmentos, convertir cada fragmento en un embedding, guardar los embeddings en un índice vectorial y, cuando llega una pregunta, recuperar los fragmentos más próximos y pasárselos al modelo para que redacte una respuesta. Herramientas como NotebookLM funcionan así, y por eso se ponen en marcha enseguida y cada pregunta se responde, más o menos, desde cero. Nuestro análisis de NotebookLM como segundo cerebro explica qué significa eso en la práctica.
Una wiki LLM traslada el trabajo al momento en que llega una fuente. El modelo lee el documento entero, decide qué importa y lo escribe en páginas que perduran. A la hora de responder lee sus propias páginas, que ya están resumidas, enlazadas y conciliadas entre sí. RAG paga por entender en cada pregunta; una wiki paga una sola vez por fuente y se queda con lo que ha comprado.
Mismo objetivo, distinto momento. Muchos sistemas reales usan los dos.
Pregunta
RAG
Wiki LLM
¿Cuándo hace el trabajo el modelo?
En cada pregunta
Una vez por fuente, en la ingesta, más pasadas periódicas de lint
¿Qué persiste entre una pregunta y otra?
Los fragmentos y sus embeddings
Resúmenes, páginas de conceptos y de entidades, enlaces, un índice y un registro
¿Puedes leerlo y corregirlo?
No fácilmente: el almacén son vectores
Sí: cada página es un archivo markdown que puedes abrir y editar
Preguntas que abarcan muchas fuentes
Dependen de recuperar a la vez todos los fragmentos relevantes
Parten de páginas de síntesis que ya conectan las fuentes
Perfil de coste
Añadir documentos es barato; cada pregunta paga la recuperación y la lectura
Cada fuente cuesta una pasada de ingesta que toca muchas páginas; las preguntas leen menos páginas, pero más densas
Tamaño cómodo
Colecciones grandes y que cambian deprisa
Unas 100 fuentes y cientos de páginas solo con el índice; a partir de ahí, hay que añadir búsqueda
Fallo típico
El pasaje correcto nunca se recupera
Una afirmación errónea se escribe en una página y se copia a otras
Comparación elaborada a partir del gist de Karpathy y del artículo original sobre RAG. La cifra de escala de la wiki es una estimación suya, no un límite estricto.
Cuándo conviene cada uno
RAG para montañas de documentos que cambian. Miles de documentos, tickets de soporte, la unidad compartida de una empresa, que cambia a diario: redactar páginas de antemano para todo eso costaría mucho más de lo que aporta. La recuperación escala; la compilación cuidadosa, no.
RAG para consultas puntuales. «¿Qué dice la cláusula 7 del contrato de alquiler?» pide el texto original exacto, no el resumen de un resumen. La recuperación lleva directamente al pasaje de la fuente.
La wiki para un tema con el que vas a convivir. Una tesis, una investigación larga, un libro que estás escribiendo: es en meses de lectura sobre un tema acotado donde la síntesis compilada se amortiza.
La wiki cuando importan las contradicciones. RAG responderá tan tranquilo con el primer fragmento que encuentre. Una wiki que señala las discrepancias en la ingesta te avisa de que el campo está dividido antes de que cites a una de las partes.
La wiki cuando quieres leer el conocimiento, no solo consultarlo. Unas páginas que puedes recorrer, enlazar y corregir son algo muy distinto de un índice al que solo puedes hacer preguntas.
Los dos se combinan bien. Lo que añadió el propio Karpathy fue un pequeño buscador sobre la wiki que el agente podía llamar desde la línea de comandos para consultas más grandes, y el gist recomienda qmd, un buscador local para archivos markdown con licencia MIT, con búsqueda por palabras clave, vectorial e híbrida y reordenación de resultados con un modelo, todo en tu máquina, y que funciona como herramienta de línea de comandos y como servidor MCP. Eso es RAG sobre una wiki: la recuperación encuentra las páginas y las páginas aportan la síntesis. Una tercera opción, pegarlo todo en una ventana de contexto muy larga, la tratamos en nuestro artículo sobre ventanas de contexto de un millón de tokens (en inglés); funciona durante un tiempo y después se vuelve cara y lenta.
Qué necesitas antes de empezar
Pieza
Para qué sirve
Coste en noviembre de 2026
Obsidian
El editor en el que lees y recorres la wiki: enlaces, enlaces entrantes (backlinks), vista de grafo
Gratis para uso personal y profesional, sin necesidad de cuenta. Sync, opcional, cuesta 4 $ al mes con facturación anual o 5 $ con pago mensual (USD), según la página de precios de Obsidian.
Obsidian Web Clipper
Una extensión del navegador que guarda páginas web en tu bóveda
Gratis; la página del Web Clipper indica que su código es abierto y que no recopila datos ni métricas de uso.
Claude Code
El agente que lee las fuentes y escribe las páginas
Requiere un plan de pago. Pro cuesta 20 $ al mes, o 17 $ al mes con facturación anual (200 $ por adelantado); Max, 100 $ al mes; Ultra, 200 $ al mes (USD), según los precios de Claude. El plan gratuito de Claude no incluye Claude Code. La otra opción es la API, con facturación por token.
git
Historial de versiones, para que cada cambio del agente se pueda revisar y deshacer
Gratis y opcional, pero muy recomendable.
qmd u otra herramienta de búsqueda
Búsqueda para cuando el índice ya no le baste a la wiki
Gratis y opcional; no la necesitarás en las primeras cien fuentes, más o menos.
Precios tomados de la página oficial de cada producto, consultados en noviembre de 2026. Pueden aplicarse impuestos.
La página de instalación de Anthropic indica como requisitos macOS 13 o posterior, Windows 10 o posterior o versiones recientes de Ubuntu y Debian, al menos 4 GB de RAM y conexión a internet. La conexión importa: el agente se ejecuta en tu ordenador, pero el modelo con el que habla funciona en la nube de Anthropic, así que nada de esto funciona sin conexión.
Claude Code no es la única opción. El gist de Karpathy menciona también Codex de OpenAI y OpenCode, y todo lo que sigue se traslada a ellos con un archivo AGENTS.md en lugar de CLAUDE.md.
En cuanto al consumo, conviene ser realista. Los planes de suscripción incluyen uso de Claude Code hasta un límite, y el uso de la API se factura por tokens. La documentación sobre costes de Anthropic explica que el consumo de tokens crece con el tamaño del contexto, da una media en empresas de unos 13 $ por desarrollador y día activo en tareas de programación y aconseja limpiar la sesión entre tareas que no tienen relación. Una wiki no es una base de código, así que toma esa cifra como una señal de que las sesiones largas con un agente acaban sumando, no como una previsión. El comando /usage de Claude Code muestra qué parte de tu plan está consumiendo una sesión.
La configuración, paso a paso
Esta es una configuración completa y mínima de un segundo cerebro con Claude y Obsidian. Lleva una tarde, que se va sobre todo en escribir el esquema y leer las primeras páginas que produce el agente.
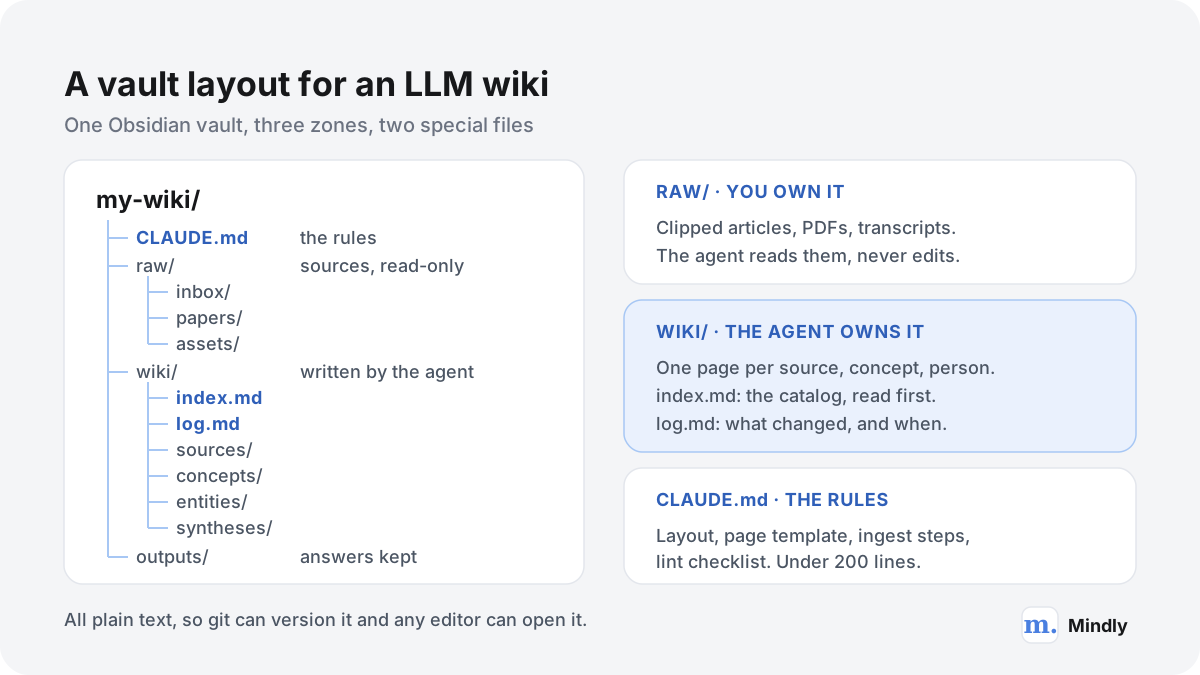
Crea la carpeta. Crea una carpeta llamada my-wiki con cuatro subcarpetas: raw (con inbox, papers y assets dentro), wiki y outputs. Mantenla fuera de iCloud Drive, Dropbox o cualquier carpeta compartida hasta que hayas decidido qué va a contener.
Ábrela como bóveda. En Obsidian, elige abrir una carpeta como bóveda y selecciona my-wiki. Obsidian añade su propia carpeta oculta de ajustes, .obsidian, y por lo demás deja tus archivos como están.
Guarda las imágenes en local. Consejo de Karpathy: en los ajustes de Obsidian, apartado Files and links (Archivos y enlaces), pon raw/assets como ruta de la carpeta de adjuntos; luego, en Hotkeys (Atajos de teclado), busca «Download attachments for current file» y asígnale un atajo. Después de guardar un artículo con el Web Clipper, púlsalo y las imágenes se descargan al disco, de modo que el agente puede verlas en lugar de depender de enlaces que pueden romperse.
Instala el Web Clipper. Añade Obsidian Web Clipper a tu navegador y elige raw/inbox como la carpeta en la que guarda. A partir de ahí, cualquier artículo se convierte en un archivo markdown en tu carpeta inbox con dos clics.
Instala Claude Code. En un Mac, abre Terminal y ejecuta el instalador de la página de instalación de Anthropic: curl -fsSL https://claude.ai/install.sh | bash. Abre una ventana nueva de Terminal y ejecuta claude --version para comprobar que ha funcionado.
Pon la bóveda bajo control de versiones. En el terminal, entra en la carpeta (cd seguido de su ruta) y ejecuta git init; después haz un primer commit. El gist recuerda que la wiki no es más que un repositorio git de archivos markdown, lo que te da historial y la posibilidad de deshacer sin coste alguno.
Arranca el agente en la bóveda. Ejecuta claude desde dentro de la carpeta e inicia sesión cuando te lo pida. Quédate en el modo predeterminado, que pide permiso antes de cada edición y cada comando, hasta que las rutinas se hayan ganado tu confianza. Pulsa Shift+Tab para pasar al modo plan (plan mode) cuando quieras que el agente te haga una propuesta antes de tocar nada.
Escribe el esquema. Pega el gist de Karpathy en la sesión, describe tu tema en dos o tres frases y pídele al agente que redacte un CLAUDE.md para esta bóveda. Después edita tú el borrador, con la plantilla de más abajo como lista de comprobación. Que sea breve.
Incorpora una fuente y lee todo lo que ha tocado. Guarda un artículo que conozcas bien, pídele al agente que lo incorpore y abre todas las páginas que haya creado o modificado. Revisas tanto las convenciones como el contenido: nombres de página, estilo de los enlaces, citas, la línea del índice.
Corrige el esquema, haz commit y repite. Cada corrección que hagas a mano debería convertirse en una regla. Tras cinco o diez fuentes, la rutina suele asentarse.
Una bóveda, tres zonas. Todo es texto plano, así que cualquier editor y git pueden leerlo.
Un CLAUDE.md para empezar
Aquí tienes un esquema de partida, escrito sección por sección tal como aparecería en el archivo. Sustituye el tema, quita lo que no necesites y deja el conjunto muy por debajo de las 200 líneas que Anthropic recomienda para un CLAUDE.md.
Propósito. Esta bóveda es una wiki de investigación sobre [tu tema]. Yo selecciono las fuentes en raw/. Tú escribes y mantienes todo lo que hay en wiki/. Tu trabajo es administrativo: resumir, enlazar, archivar y señalar, no decidir qué es verdad.
Estructura. raw/ es de solo lectura: nunca edites, renombres ni borres nada de su interior. wiki/sources/ tiene una página por fuente, con el nombre de la fuente. wiki/concepts/ recoge ideas y métodos; wiki/entities/, personas, organizaciones y conjuntos de datos; wiki/syntheses/, las respuestas y comparaciones que te pida conservar. wiki/index.md y wiki/log.md se describen más abajo. outputs/ guarda presentaciones y gráficos.
Formato de página. Cada página empieza con propiedades: tipo, fuentes (un recuento), actualizado (una fecha). Usa [[wikilinks]] en cada mención de una página existente. Cada frase que afirma un hecho termina con un enlace a la página de fuente de la que procede. Cuando las fuentes discrepan, la página tiene una sección llamada Discrepancias.
Índice y registro. index.md enumera todas las páginas por categoría, con un enlace y una línea de resumen; actualízalo con cada cambio. En log.md solo se añaden entradas; cada una empieza por ## [AAAA-MM-DD] seguido de ingest, query o lint, una barra vertical y un título.
Responder preguntas. Lee primero index.md y después las páginas que necesites. Responde solo a partir de la wiki y cita las páginas usadas. Si la wiki no contiene la respuesta, dilo y sugiere qué fuente incorporar. Ofrece guardar las respuestas útiles en wiki/syntheses/.
Nunca. Nunca inventes una cita ni una fuente. Nunca borres una página: márcala como sustituida y enlaza la que la reemplaza. Nunca hagas una búsqueda web ni descargues una página sin preguntar antes. Nunca toques archivos fuera de esta carpeta.
Fíjate en lo que falta: las rutinas paso a paso de ingesta y de lint. Son largas y solo hacen falta cuando las ejecutas, así que su sitio son las skills, de las que hablamos a continuación. Escribir para un modelo es una pequeña destreza en sí misma; nuestra guía sobre notas que una IA puede leer de verdad (en inglés) cubre la parte de redacción.
La rutina de ingesta
En la ingesta es donde la wiki se hace o se echa a perder. Una buena rutina es lenta a propósito durante las primeras semanas.
Deja la fuente en raw/inbox. Un artículo guardado con el Web Clipper, un PDF, una transcripción, una página de tus propias notas. Un archivo por fuente.
Invoca la rutina. Escribe /ingest seguido del nombre del archivo. El agente lee el esquema, el índice y la fuente.
Comenta antes de escribir. El agente enumera los cinco puntos más importantes y las páginas existentes que piensa modificar, y te pregunta qué destacar. Es el momento en que Karpathy repasa las conclusiones con el modelo, y es donde detectas una mala lectura antes de que se propague.
Escribe la página de fuente. Un resumen en wiki/sources/, con las afirmaciones clave, los métodos, las limitaciones que reconocen los propios autores y un enlace al archivo original.
Actualiza conceptos y entidades. Párrafos nuevos en las páginas existentes, páginas nuevas cuando un concepto aparece por segunda vez, y cada frase enlazada a la página de fuente.
Señala los conflictos. Cuando la fuente contradice una página, se añade una entrada breve en la sección Discrepancias de ambas páginas, con el nombre de las dos fuentes.
Actualiza el índice y el registro. Una línea por cada página nueva en index.md y una entrada en log.md con todas las páginas modificadas.
Revisa y haz commit. El agente te pasa la lista de archivos modificados. Tú los lees, revisas el git diff y haces commit con el título de la fuente como mensaje. Después mueves tú el archivo de raw/inbox a su carpeta definitiva.
Conviértela en un comando
En Claude Code, una rutina que ejecutas a menudo se convierte en una skill: una carpeta dentro de .claude/skills, en la bóveda, que contiene un archivo SKILL.md. El archivo empieza con una descripción breve, que Claude usa para decidir cuándo se aplica la skill, seguida de los pasos anteriores redactados como instrucciones. Una skill guardada en una carpeta llamada ingest se ejecuta escribiendo /ingest, y solo se carga cuando la invocas, lo que mantiene pequeño el CLAUDE.md, que se carga siempre. Crea una segunda para el lint. Los antiguos archivos de comandos personalizados en .claude/commands siguen funcionando, pero las skills son el formato que Anthropic recomienda para lo nuevo.
Ejemplo de página de fuente (ilustrativo)
sources/2026-03 Estudio de campo sobre el arbolado urbano
Tipo: fuente. Archivo original: raw/papers/canopy-field-study.pdf. Resumen: estudio de campo de un verano que compara la temperatura de las calles bajo la copa de los árboles con la de calles cercanas sin sombra en una misma ciudad. Afirmaciones clave: las calles con sombra registraron temperaturas más bajas a ras de suelo por la tarde; el efecto fue mayor en los días más calurosos. Método: lecturas de temperatura superficial, no del aire, algo que importa al compararlo con otras fuentes. Limitaciones que reconocen los autores: una sola ciudad, un solo verano. Discrepancias: registra un efecto mayor que [[sources/2025-11 Modelo regional de temperatura del aire]]; probablemente se explica por la diferencia de medición, véase [[concepts/Temperatura superficial frente a temperatura del aire]].
Modificadas en la ingesta: concepts/Arbolado urbano y calor · concepts/Temperatura superficial frente a temperatura del aire · entities/Servicio municipal de parques y jardines · index.md · log.md
Preguntar, archivar las respuestas y el lint semanal
Con unas cuantas decenas de fuentes dentro, la wiki empieza a devolver lo invertido: las preguntas se responden a partir de páginas que ya conectan tus lecturas, y una revisión periódica mantiene esas páginas honestas.
Preguntar es una conversación normal con el agente en la bóveda. El agente lee el índice, abre las páginas relevantes y redacta una respuesta que las cita. Las preguntas que mejor funcionan son las que un buscador no puede responder: en qué coinciden mis fuentes, dónde discrepan y por qué, qué afirmación se apoya en una sola fuente, qué ha cambiado en lo que entiendo desde marzo. A Karpathy le gustan las respuestas en forma de archivo más que como texto en el terminal: páginas markdown, presentaciones en formato Marp o gráficos dibujados con matplotlib, que se abren todos en Obsidian. Si tus páginas llevan propiedades como fechas y recuentos de fuentes, el plugin Dataview, que el gist también menciona, puede convertirlas en tablas dinámicas.
El paso que hace que el sistema gane valor con el tiempo es devolver a la wiki las buenas respuestas. Una comparación que vas a querer consultar otra vez va a wiki/syntheses con enlaces a todas las páginas en las que se basa, y recibe una línea en el índice y una entrada en el registro. Aquí hay una regla que importa más que ninguna otra: el agente tiene que decir cuándo la wiki no contiene la respuesta. Si no, rellena el hueco con el conocimiento general del modelo, y una respuesta sin fuentes acaba archivada como si saliera de tus lecturas.
Una página de síntesis archivada (ilustrativa)
syntheses/¿Enfría el arbolado urbano lo suficiente como para importar?
Pregunta formulada el 2026-04-21. Respuesta breve: en las 14 fuentes, la sombra reduce de forma constante la temperatura superficial a ras de suelo; los efectos sobre la temperatura del aire son menores y varían según la trama urbana. Pruebas más sólidas: [[sources/2026-03 Estudio de campo sobre el arbolado urbano]], [[sources/2025-08 Comparación por satélite entre varias ciudades]]. Eslabón más débil: las cifras de coste-beneficio se apoyan en un solo informe, [[sources/2024 Revisión presupuestaria del ayuntamiento]]. Pregunta abierta: ninguna fuente cubre los efectos nocturnos. Próxima fuente sugerida: un estudio que mida la temperatura del aire de noche.
Elaborada a partir de: 9 páginas de fuentes · 3 páginas de conceptos
El lint semanal
El lint es un chequeo que ejecutas con una segunda skill, más o menos una vez por semana o después de cualquier ingesta por lotes. Pídele al agente que primero informe sin cambiar nada y luego decide qué correcciones aceptas.
Contradicciones. Páginas que afirman cosas incompatibles, sobre todo donde todavía no hay una entrada de Discrepancias.
Afirmaciones desfasadas. Datos que una fuente más reciente ha dejado atrás y que siguen en páginas de conceptos o de síntesis.
Huérfanas. Páginas a las que no enlaza ninguna otra. La vista de grafo de Obsidian dibuja las notas como círculos y los enlaces como líneas, y tiene un interruptor para mostrar las huérfanas, así que se ven enseguida.
Páginas que faltan. Conceptos mencionados en varias páginas que no tienen página propia.
Enlaces que faltan. Menciones de páginas existentes escritas como texto plano en lugar de como enlaces.
Frases sin cita. Frases que afirman un hecho sin enlace a una página de fuente. Es el punto más importante de la lista.
Índice descuadrado. Entradas del índice que apuntan a páginas que ya no existen, y páginas que no figuran en el índice.
Lagunas. Preguntas abiertas que una fuente nueva podría responder. Karpathy usa aquí la búsqueda web para completar los datos que faltan; mejor que eso solo ocurra con un sí explícito por tu parte.
Un informe de lint (ilustrativo)
## [2026-04-26] lint | Revisión de la semana 4
2 contradicciones: concepts/Arbolado urbano y calor dice que los efectos son «máximos a mediodía» y sources/2026-03 dice «por la tarde»; la síntesis cita ambas. 1 afirmación desfasada: la visión general sigue dando la cifra de plantación de 2024, superada por el informe municipal de 2026. 3 huérfanas: entities/Empresa contratista de la encuesta, concepts/Albedo, sources/2025 Episodio 41 del pódcast. 4 frases sin cita en concepts/Isla de calor urbana. 1 página que falta: «tamaño del alcorque», mencionado en 4 páginas. No se ha hecho ningún cambio. Responde con los números que quieras corregir.
Siguiente paso: corregir primero las frases sin cita · volver a pasar el lint después
Las señales de deriva saltan a la vista en cuanto te fijas: el índice y la carpeta no coinciden en cuántas páginas hay, el mismo concepto tiene dos páginas con nombres ligeramente distintos, las páginas de síntesis dejan de actualizarse tras las nuevas ingestas o te sorprendes buscando en la carpeta raw porque ya no te fías de la wiki. Cualquiera de ellas es motivo para una pasada de lint y una edición del esquema, no para empezar de cero.
Un ejemplo práctico: 30 fuentes en un mes
Un caso ilustrativo, con fuentes inventadas: una analista tiene cuatro semanas para explicar al ayuntamiento si plantar árboles en las calles compensa como respuesta al calor del verano.
La lista de lectura suma 30 fuentes: 20 artículos científicos, 6 informes municipales y de organismos públicos y 4 charlas grabadas, guardadas como transcripciones. La analista prepara la bóveda un lunes por la tarde, escribe el esquema e incorpora la primera fuente el martes. Las cifras de la tabla son lo que podría producir una rutina cuidadosa en este ejemplo, no mediciones.
Semana
Qué ocurre
La wiki al final de la semana
1
Configuración, esquema y 6 fuentes incorporadas de una en una. El esquema se retoca después de casi cada ingesta: nombres de página, formato de las citas, una regla nueva para separar la temperatura superficial de la del aire.
6 páginas de fuentes, 9 de conceptos, 4 de entidades, índice y registro
2
10 fuentes más, todavía de una en una, unos 20 minutos cada una contando la lectura de las páginas modificadas. Aparecen las primeras entradas de Discrepancias.
16 páginas de fuentes, 17 conceptos, 8 entidades
3
Las 4 transcripciones se incorporan por lotes, y después otros 10 artículos científicos de uno en uno. La primera pasada de lint encuentra 3 huérfanas y 6 frases sin cita.
30 páginas de fuentes, 24 conceptos, 11 entidades
4
Preguntas en lugar de ingestas: 5 respuestas archivadas como páginas de síntesis, una presentación en Marp para el ayuntamiento y una segunda pasada de lint.
Unas 75 páginas, 5 síntesis, 1 presentación en outputs/
Cifras ilustrativas. Los recuentos reales dependen por completo del tema y del esquema.
Una página de concepto tras la semana 3 (ilustrativa)
concepts/Temperatura superficial frente a temperatura del aire
Muchas fuentes miden cuánto se calientan el suelo y las paredes (temperatura superficial); menos miden el aire que respira la gente (temperatura del aire). Bajo la sombra, las diferencias de temperatura superficial son sistemáticamente mayores que las del aire [[sources/2026-03 Estudio de campo sobre el arbolado urbano]] [[sources/2025-08 Comparación por satélite entre varias ciudades]]. Discrepancias: el modelo regional de [[sources/2025-11 Modelo regional de temperatura del aire]] encuentra efectos pequeños sobre la temperatura del aire y a menudo se cita como si contradijera el estudio de campo; los dos miden cosas distintas. Por qué importa para el informe: las afirmaciones sobre confort y salud necesitan la temperatura del aire o la sensación térmica, no lecturas de superficie.
Enlazada desde: 11 páginas · Fuentes: 7
Las últimas líneas del registro (ilustrativo)
wiki/log.md
## [2026-04-24] ingest | Revisión presupuestaria del ayuntamiento 2024 (6 páginas modificadas). ## [2026-04-25] query | ¿Qué costes se apoyan en una sola fuente? (archivada como syntheses/Mapa de pruebas sobre costes). ## [2026-04-26] lint | Revisión de la semana 4 (14 incidencias, 11 corregidas). ## [2026-04-27] query | Borrador de las diapositivas para el ayuntamiento (outputs/council-briefing.md).
Lo que hace que funcione en este ejemplo no es la inteligencia del modelo, sino tres hábitos: leer cada página modificada durante las dos primeras semanas, la regla de las citas y escribir en el esquema la distinción entre superficie y aire la primera vez que causó confusión. El coste es tiempo, sobre todo de lectura, y un mes de sesiones del agente con un plan de pago. La recompensa es un informe en el que cada afirmación se puede rastrear hasta una página y cada página hasta una fuente, y una wiki a la que la analista puede volver el verano que viene.
Una variante más ligera encaja mejor con un año de lecturas que con un proyecto de investigación. Al terminar cada libro, incorpora sus subrayados y tus propias notas, una fuente por libro, y deja que el modelo mantenga páginas para las ideas, los autores y los argumentos que se repiten. Al cabo de 20 libros tienes un mapa de lo que has leído y de cómo se conecta, que es lo que nuestra guía sobre cómo recordar lo que lees (en inglés) intenta conseguir a mano.
Riesgos y límites
El patrón es útil y es nuevo. La mayoría de sus problemas nacen del mismo sitio que su fuerza: es un modelo quien escribe tu base de conocimiento.
Errores que se acumulan
En un sistema RAG, una respuesta errónea suele quedarse en algo puntual. En una wiki, un resumen erróneo se convierte en una página, la siguiente ingesta enlaza a ella, una síntesis la cita y, un año después, parece un hecho asentado. Los enlaces alucinados son la versión visible: un enlace a una página o a una fuente que no existe. Las afirmaciones inventadas o distorsionadas son la versión peligrosa. Las defensas son las de esta guía: fuentes que nunca se editan, una cita en cada frase que afirma un hecho, una pasada de lint que liste las frases sin cita y el historial de git para ver cuándo apareció una afirmación. Nada de esto quita la necesidad de leer. El autor de R&D World, tras un mes con una wiki de unas 760 páginas, seguía considerando necesaria la verificación manual y describía el riesgo de alucinación como reducido, no eliminado.
Privacidad: tus archivos van a un proveedor de modelos
Claude Code se ejecuta en tu ordenador, pero para hacer cualquier cosa envía a Anthropic, por una conexión cifrada, tus prompts y las respuestas del modelo, incluido el contenido de los archivos que lee para hacer el trabajo. La página sobre el uso de datos de Anthropic dice que en los planes para particulares (Free, Pro, Max y Ultra) tú decides si tus datos pueden usarse para mejorar modelos futuros, con un periodo de conservación de 5 años si lo permites y de 30 días si no, y que los planes comerciales y la API no se usan para entrenar por defecto. Claude Code también guarda en tu propia máquina las transcripciones de las sesiones, en texto plano, durante 30 días por defecto. Comprueba la opción de entrenamiento antes de incorporar nada personal, y piénsatelo dos veces con material de salud, jurídico o de clientes. Conectar más herramientas al mismo agente aumenta lo que está en juego; explicamos por qué en fugas de datos con MCP: cuando los agentes lo conectan todo (en inglés), y la cuestión más amplia de quién controla tu contexto en la guerra por la memoria de la IA (en inglés).
Coste y límites de uso
Cada ingesta lee una fuente y reescribe varias páginas, y cada pregunta lee el índice y un puñado de páginas, así que una wiki que crece gasta más tokens por operación. Con una suscripción, eso se nota en que llegas antes a los límites de uso; con la API, se nota en la factura. Según las recomendaciones de Anthropic sobre costes, ayuda limpiar la sesión entre ingestas, mantener el esquema breve y usar un modelo más barato para las pasadas rutinarias. Un modelo local evita tanto la factura como la cuestión de la privacidad, a cambio de resultados más flojos por ahora; nuestro artículo sobre la IA local en tu portátil (en inglés) cuenta qué funciona bien.
Mantenimiento y deriva
La promesa del gist es que el mantenimiento pasa a ser casi gratuito. En la práctica pasa a ser barato, pero no automático. La wiki solo cambia cuando ejecutas una ingesta o un lint, y el esquema necesita retoques a medida que crece el tema. El informe de R&D World constató que la wiki no se actualizaba sola por defecto, que la supervisión automática solo estaba conectada en parte y que, para temas bien cubiertos en la web abierta, quizá no compensara el esfuerzo. Su veredicto fue que resultaba moderadamente útil y prometedora para casos concretos, lo que encaja con el propio diseño del patrón: un tema, fuentes escogidas y una persona supervisando.
Escala y dependencia
El enfoque basado solo en el índice resulta cómodo hasta un centenar de fuentes y unos pocos cientos de páginas, según la estimación de Karpathy. A partir de ahí el agente necesita búsqueda y, a la larga, acabas manteniendo un sistema RAG sobre tu wiki, lo cual está bien, pero ya no es sencillo. La dependencia, en cambio, es baja: todo es markdown en una carpeta, legible con cualquier editor, el tipo de formato que sobrevive a las apps que lo rodean (en inglés). Si dejas de usar el agente, te quedas con las páginas.
Su relación con los métodos clásicos
La wiki LLM toma su forma de métodos de toma de notas más antiguos y cambia una sola cosa: quién escribe.
Su antecesor más cercano es el Zettelkasten, la caja de fichas del sociólogo Niklas Luhmann, que escribió unas 90.000 notas entre 1951 y 1996, según el archivo Luhmann de la Universidad de Bielefeld. Notas breves, cada una enlazada con otras, y un índice de todo el conjunto: es casi exactamente la estructura de la wiki. La diferencia está en el sentido del método. Luhmann escribía personalmente cada nota, con sus propias palabras, y era al escribir cuando pensaba. En una wiki LLM las notas las escribe el modelo, así que obtienes la estructura sin el pensamiento, salvo que pienses en otro sitio: en las preguntas que haces y en las síntesis que pones en duda.
Carpetas según lo cerca que estén de la acción; un flujo de trabajo de la captura a la expresión
La wiki es un único Recurso de investigación; Expresar pasa a ser las respuestas archivadas
La estructura resulta familiar. Lo nuevo es que es un modelo quien archiva y enlaza.
Las notas evergreen, en particular, son la mejor referencia de cómo deben ser unas buenas páginas de conceptos: con un título que enuncia una afirmación o un concepto, escritas para leerse sin tener la fuente abierta, y actualizadas en lugar de duplicadas. Pedirle al agente que escriba así las páginas de conceptos es una de las líneas más útiles que puede tener un esquema. Una wiki que publicas, como hizo el autor de R&D World con parte de la suya, se convierte en un jardín digital con un jardinero que nunca duerme, lo que sube todavía más el listón de las citas, porque la leerán desconocidos.
Mucha gente quiere el resultado, un segundo cerebro que se organiza solo, sin tener que supervisar a un agente en la línea de comandos. Hay opciones honestas, cada una con su contrapartida.
Vía
Qué obtienes
A qué renuncias
Claude Code en la app de escritorio de Anthropic
El mismo agente y el mismo patrón, manejados desde una ventana en lugar de un terminal
Solo al terminal: sigue siendo un agente que edita tus archivos bajo tu supervisión, con un plan de pago
Una herramienta RAG como NotebookLM
Subes las fuentes y chateas con ellas en cuestión de minutos
Nada se acumula entre preguntas; no hay páginas tuyas que puedas editar
Una app que organiza automáticamente, como Mindly
Etiquetas, resúmenes, conexiones y búsqueda en lenguaje natural sobre todo lo que guardas, sin configurar nada
No hay páginas de wiki compiladas ni acceso de agentes a la biblioteca
Un asistente de chat más Obsidian, a mano
Pegas una fuente, pides una página de resumen y la pegas en una bóveda
Te conviertes en el archivero al que el patrón venía a sustituir
Resumen de las contrapartidas descritas en esta guía, a noviembre de 2026.
La vía de escritorio es la que mantiene intacto el patrón, y la página de instalación de Anthropic remite a la app de escritorio a quien prefiere una interfaz gráfica. La vía RAG es la de arranque más rápido y la más floja en síntesis, como muestra la comparación anterior; repasamos las opciones en alternativas a NotebookLM (en inglés) y el enfoque general en cómo chatear con tus documentos (en inglés). La vía de la organización automática es la más alejada de la idea de Karpathy y la más cercana a lo que mucha gente entiende por segundo cerebro (en inglés) o base de conocimiento personal (en inglés): tú sigues guardando y otra cosa se encarga de que todo se pueda encontrar.
Qué aporta Mindly
Dónde encaja Mindly y dónde no
Mindly no es una wiki LLM, y sería engañoso presentarla como tal. No compila lo que guardas en páginas de wiki enlazadas entre sí, y no deja que Claude Code ni ningún otro agente lea o escriba en su biblioteca: no hay servidor MCP ni API. Si quieres el patrón de Karpathy tal cual, la configuración con Claude Code y Obsidian de más arriba es la forma de construirlo, y nuestra comparativa con Obsidian (en inglés) reconoce sin rodeos lo que Obsidian hace mejor. Lo que cubre Mindly es una parte más pequeña del mismo deseo: un sitio en tu Mac donde guardar algo cuesta un atajo de teclado y la organización ocurre sin esquema. Enlaces, PDF, notas, capturas de pantalla, notas de voz y vídeos de YouTube se etiquetan por tema y se resumen (en inglés) al guardarlos, los elementos relacionados u olvidados vuelven a aparecer como sugerencias inteligentes (en inglés), la búsqueda funciona en lenguaje natural (en inglés) en todos los formatos y puedes chatear con cualquier elemento (en inglés) y obtener respuestas basadas en tu propio material. La biblioteca se guarda en local, en una carpeta de Mindly, y las peticiones de IA viajan por canales cifrados sin que el contenido se quede después en los servidores de Mindly. Es solo una app para Mac, para macOS 14 o posterior, y todavía no hay app para iPhone. Puede que a algunas personas les interesen las dos cosas: Mindly como el sitio sin esfuerzo para todo lo que se van encontrando, y una wiki LLM llevada a mano para el tema que investigan a fondo. Pasar material de una a otra es manual, porque Mindly no da acceso a agentes. El plan gratuito admite 25 elementos, suficiente para ver si la organización automática era todo lo que necesitabas antes de montar una wiki.
Preguntas frecuentes
Preguntas frecuentes sobre la LLM wiki
¿Qué es una LLM wiki?
Una base de conocimiento personal que un agente de IA escribe y mantiene como una carpeta de páginas markdown enlazadas entre sí. Tú añades fuentes a una carpeta de solo lectura; el agente resume cada una, actualiza las páginas de los conceptos y las personas implicadas, mantiene un índice y un registro, responde a preguntas a partir de las páginas y las revisa de vez en cuando en busca de contradicciones y lagunas. Andrej Karpathy describió el patrón en abril de 2026.
¿Qué publicó exactamente Karpathy, y cuándo?
Dos cosas. El 2 de abril de 2026 publicó «LLM Knowledge Bases» en X, donde describía su propio sistema: fuentes en una carpeta raw, una wiki compilada por un LLM, Obsidian como visor y una wiki de investigación de unos 100 artículos y 400.000 palabras. El 4 de abril publicó un «archivo de ideas» (idea file) como gist de GitHub titulado «LLM Wiki», pensado para pegarlo en un agente como Claude Code o Codex y que este monte una versión para ti. Ninguno de los dos es software; ambos describen un patrón.
LLM wiki o RAG: ¿cuál es mejor?
Ninguno, en general. RAG recupera fragmentos de tus documentos en el momento de la pregunta y se adapta bien a colecciones grandes y cambiantes y a las consultas puntuales. Una LLM wiki hace la lectura una sola vez, en la ingesta, y guarda la síntesis en forma de páginas, lo que encaja con un tema que vas a estudiar durante meses y con preguntas que abarcan muchas fuentes. A Karpathy le bastó un archivo de índice con unas 100 fuentes; más allá, la mayoría de los sistemas añaden búsqueda sobre la wiki y combinan los dos enfoques.
¿Cómo monto un segundo cerebro con Claude y Obsidian?
Crea una carpeta con las subcarpetas raw, wiki y outputs y ábrela como bóveda de Obsidian. Instala Obsidian Web Clipper para guardar artículos en raw, instala Claude Code, pon la carpeta bajo git, ejecuta claude dentro de ella y escribe un CLAUDE.md que fije la estructura, el formato de página y las reglas. Después incorpora una fuente, lee todas las páginas que haya tocado, corrige las reglas y repite. Claude Code requiere un plan de pago de Claude; Obsidian es gratis.
¿Necesito Claude Code o sirve otro agente?
Sirve cualquier agente competente que pueda leer y escribir archivos. El gist de Karpathy menciona Codex de OpenAI y OpenCode junto a Claude Code. El archivo de esquema cambia de nombre (AGENTS.md es el habitual), y el propio Claude Code lee un AGENTS.md cuando la carpeta no tiene CLAUDE.md. Los asistentes de chat sin acceso a archivos solo pueden imitar el patrón, contigo copiando páginas de un lado a otro.
¿Cuánto cuesta mantener una LLM wiki?
Obsidian es gratis para uso personal y profesional. Claude Code requiere un plan de pago: en noviembre de 2026, Pro cuesta 20 $ al mes, o 17 $ al mes con facturación anual, y Max y Ultra cuestan 100 $ y 200 $ al mes, todo en USD; el plan gratuito de Claude no lo incluye. La alternativa es la API, con facturación por token. Las sesiones de ingesta intensivas agotan antes los límites del plan, porque cada fuente reescribe varias páginas.
¿Es privada una LLM wiki?
Los archivos están en tu ordenador, pero el agente envía lo que lee al proveedor del modelo para hacer su trabajo. En los planes de Claude para particulares tú decides si tus datos pueden usarse para mejorar los modelos; Anthropic los conserva 5 años si lo permites y 30 días si no. Los planes comerciales y la API no se usan para entrenar por defecto. Revisa esa opción antes de incorporar material personal, de salud, jurídico o de clientes.
¿Hasta dónde puede crecer una LLM wiki?
Karpathy cuenta que dejar que el agente se oriente con index.md funciona a escala moderada, con unas 100 fuentes y unos pocos cientos de páginas. Más allá, el agente necesita una búsqueda de verdad sobre las páginas, como qmd, un buscador local de markdown que recomienda el gist. El límite práctico suele ser tu tiempo para revisar ingestas e informes de lint, más que el software.
¿Puedo crear una LLM wiki sin programar?
No hace falta programar, pero la configuración habitual exige usar un terminal y soltura para supervisar a un agente. Claude Code también funciona en la app de escritorio de Anthropic, que elimina el terminal pero no la supervisión. Si lo que quieres es organización automática y no una wiki compilada, apps como Mindly etiquetan, resumen, conectan y buscan lo que guardas sin configurar nada, aunque Mindly no crea páginas de wiki ni da a los agentes acceso a su biblioteca.
Fuentes
En qué se basa esta página
LLM Knowledge Bases (post on X)Andrej Karpathy · 2026La descripción original: carpeta raw/, wiki compilada, Obsidian como interfaz, unos 100 artículos y 400.000 palabras, resultados que vuelven a archivarse, chequeos periódicos y la idea del ajuste fino (finetuning). Publicado el 2 de abril de 2026.
LLM Wiki (GitHub gist)Andrej Karpathy · 2026El archivo de ideas: tres capas, ingesta, consulta y lint, index.md y log.md, consejos y la comparación con el Memex. Creado el 4 de abril de 2026.
Is Karpathy's viral LLM wiki helpful? Mostly yesBrian Buntz, R&D World · 2026Balance de un mes con una wiki de unas 760 páginas: ventajas, tiempo de mantenimiento y el riesgo de alucinación que persiste.
How Claude remembers your projectAnthropicUbicaciones de CLAUDE.md, la recomendación de las 200 líneas, las importaciones y la compatibilidad con AGENTS.md.
Advanced setupAnthropicRequisitos del sistema, el comando de instalación, los planes que incluyen Claude Code y la app de escritorio.
Manage costs effectivelyAnthropicCómo crece el consumo de tokens, el comando /usage y formas de reducir el uso.
Data usageAnthropicLa opción de entrenamiento y los periodos de conservación según el plan, y qué envía Claude Code por la red.
Plans and pricingAnthropicPrecios de Pro, Max y Ultra en USD y qué planes incluyen Claude Code (consultado en noviembre de 2026).
How Obsidian stores dataObsidianLas bóvedas como carpetas locales de archivos Markdown en texto plano que otras apps pueden editar.
Obsidian Web ClipperObsidianNavegadores compatibles, código abierto y declaración de privacidad.
PricingObsidianUso personal y profesional gratuito, y precios de Sync y Publish (consultado en noviembre de 2026).
qmdGitHubEl buscador local de markdown que recomienda el gist: búsqueda por palabras clave, vectorial e híbrida, servidor MCP, licencia MIT.
Crea la bóveda, incorpora un artículo que conozcas bien y lee todas las páginas que haya tocado el agente. Si quieres que lo que guardas se organice sin ejecutar un agente, descarga Mindly y mira qué hace con los próximos 25 elementos que guardes.